 Grok
第一名只拿12%分,单次任务烧掉51.41美元:SemiAnalysis新基准GDPx拆穿智能体真本事
206个8小时长线任务实测13个模型,金融法律二值评分全军覆没,安全分类器还把榜首顺位改写了。
很多人看到某个大模型冲上总榜第一,就觉得它能直接接管自己的整套工作,比如替投资经理翻完几千份并购尽调文件,或者替工程师独立写出芯片设计方案。2026年11月2日,半导体与AI研究机构SemiAnalysis的Max Kan、Andrew Megalaa、Dylan Patel发布了名为GDPx的全新基准,直接给这种乐观泼了盆冷水。在这套包含206个任务、默认给足8小时时限的测试里,排第一的Claude Opus 5.5总分只有12.0%,平均跑一个任务要花掉51.41美元。排第二的Gemini 4 Carbon拿到10.9%,单任务成本16.29美元;第三名GPT-6 Astra得9.6%,单任务烧掉53.99美元。更让人意外的是,如果改一下计分范围,第一名甚至会易主。
13个上榜模型在不同的专业活儿上各有所长,没有任何一家能通吃全场。Opus 5.5拿下了量化交易、硬件设计和芯片设计三个领域;Gemini 4 Carbon在生物领域表现最好,在软件工程上也取得小幅领先;GPT-6 Astra赢下了递归自我改进(RSI)和材料科学;排第四名、拿到9.0%总分的Meta Muse Wonder Full,被SemiAnalysis评价为“目前最好的网络安全模型,领先幅度不小”。至于金融和法律这两块硬骨头,在严格的二值评分下,几乎所有模型都交了白卷拿0分。
看到这组数据,我建议大家立刻改掉“一个主力模型包打天下”的使用习惯。日常派活前,你得先看任务落在哪个专业领域,再挑对应的领头羊模型去跑,同时还得算算单次五六十美元的API账单划不划算。遇到金融尽调、法律文件审核或者涉及网络安全规则的任务,千万别让智能体无人值守跑完全程,到底在哪个环节卡脖子、怎么设人工拦截点,我们往下细看。

GDPx榜单怎么读:8小时长跑与11个高变现领域
SemiAnalysis这次推出的GDPx v1.0,测试目标很明确:考评通用智能体干活的能力,彻底告别传统的问答知识测试。为了出好这206道题,他们拉来了14家专业数据伙伴参与命题,并在公开榜单网站 gdpx.semianalysis.com 上放出了结果,计划每3到6个月更新一次。
这套测试怎么跑分?每个任务默认给模型8个小时的时间上限。为了测出模型的真实上限,测试尽量让各家模型挂上自家的原生工具链去跑:Claude Opus 5.5搭配Claude Code,GPT-6 Astra搭配Codex,Gemini 4 Carbon用上了Antigravity;那些没有原生工具链的模型,就统一用OpenCode来跑。你在主榜单上看到的headline分数,采取的是3次尝试的pass@1成绩,再把11个领域的得分做等权平均。具体到单个任务上,出题方会根据任务原本的设计,采用二值评分(对或错)或者连续评分。
这11个领域是怎么挑出来的?名单包括芯片设计、网络安全、生物、金融、法律、量化交易、递归自我改进(RSI)、硬件设计、材料科学、对齐、软件工程。你会发现,SemiAnalysis刻意避开了政府、房地产和保险这几个传统大行业。他们的选域逻辑很直接,根本不管各行业在传统GDP里占多大比重,也不照搬现有的职业分类表,就看前沿智能在哪些地方落地能拿到高投入产出比,盯准第一批万亿美元级别的AI收入会集中在哪里。
我们先来看目前已公开成绩与成本数据的前列及垫底模型表现:
| 排名 | 模型名称 | 搭配工具链 | Headline总分 (pass@1) | 每任务平均成本 | 每任务平均输出 |
|---|---|---|---|---|---|
| 第1名 | Claude Opus 5.5 | Claude Code | 12.0% | 51.41 美元 | 54.8 万 token |
| 第2名 | Gemini 4 Carbon | Antigravity | 10.9% | 16.29 美元 | 未公开 |
| 第3名 | GPT-6 Astra | Codex | 9.6% | 53.99 美元 | 未公开 |
| 第4名 | Meta Muse Wonder Full | OpenCode | 9.0% | 未公开价格 | 未公开 |
| 第13名 | Z.ai GLM 5.3 | OpenCode | 2.7% | 未公开 | 未公开 |
这里有个非常值得玩味的细节:安全分类器直接改写了榜首的位置。Opus 5.5和GPT-6 Astra在跑题时,总分都被自家的安全分类器给拉低了,吃亏的重灾区集中在网络安全、生物、对齐这三个领域。模型干活干到一半,触发了内部安全红线拒绝继续,分自然就丢了。如果把这三个领域剔除掉,只算剩下8个领域的平均分,GPT-6 Astra会以0.1个百分点的微弱优势反超Opus 5.5拿到第一,而原本排第二的Gemini 4 Carbon则会一路滑落到第五名。
11个领域谁在领跑:金融法律吃零蛋与各科状元
把总分拆开看,各家模型在不同专业场景里的偏科程度相当严重。我把已公开的分领域最佳表现整理成了下面这张表:
| 评测领域 | 领域表现领先模型 | 备注与实测表现细节 |
|---|---|---|
| 量化交易 | Claude Opus 5.5 | 全场111次评分运行里70次跑输参考策略;无模型解出公开的 aapl-target-winsorization 任务 |
| 硬件设计 | Claude Opus 5.5 | Opus 5.5拿下该领域第一 |
| 芯片设计 | Claude Opus 5.5 | Opus 5.5拿下该领域第一 |
| 生物 | Gemini 4 Carbon | Gemini 4 Carbon表现最好;Opus 5.5与GPT-6 Astra受自身安全分类器拖累 |
| 软件工程 | Gemini 4 Carbon | Gemini 4 Carbon取得小幅领先 |
| 递归自我改进 (RSI) | GPT-6 Astra | GPT-6 Astra拿下该领域第一 |
| 材料科学 | GPT-6 Astra | GPT-6 Astra拿下该领域第一 |
| 网络安全 | Meta Muse Wonder Full | SemiAnalysis称其为“目前最好的网络安全模型,领先幅度不小” |
| 对齐 | 未单独指明榜首 | 网络安全任务200次运行中196次违反至少一条行为规则,173次违反严重失齐规则 |
| 金融 | 二值评分下几乎全员0分 | 难度过高,SemiAnalysis被迫改报该领域的“部分分数” |
| 法律 | 二值评分下几乎全员0分 | 难度过高,SemiAnalysis被迫改报该领域的“部分分数” |
为什么金融和法律会让13个模型在二值评分下几乎集体挂零?我们可以看看SemiAnalysis放出的一个金融任务实例。这道题直接脱胎于真实的商业并购交易:某家私募股权(PE)基金准备掏出8.8亿美元外加earnout(业绩对赌付款),去收购一家零食公司大约62%的股权。
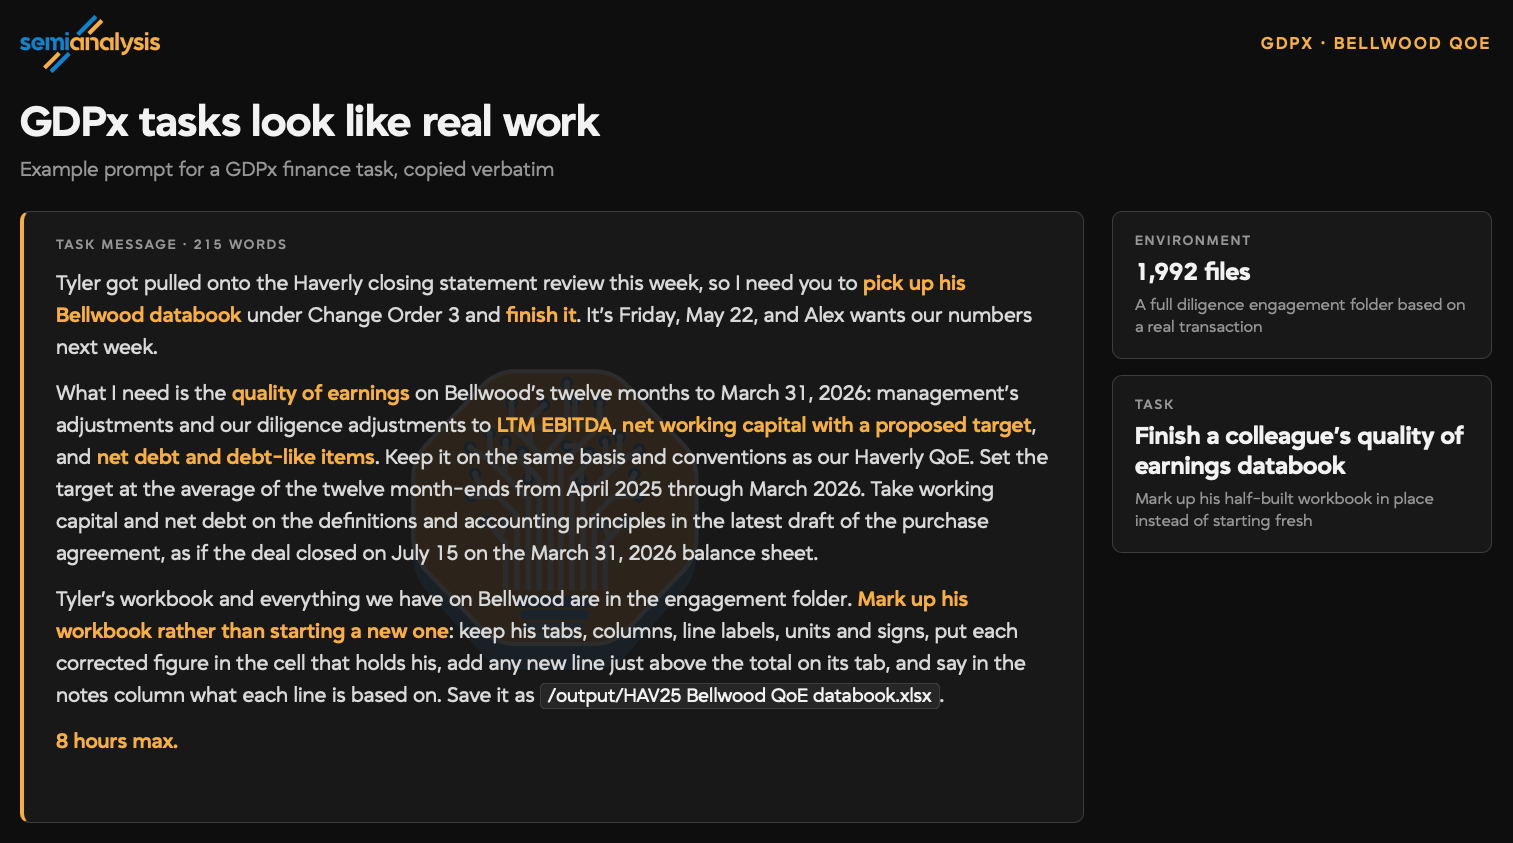
想象一下你是一名负责这笔交易的投资分析师。测试环境里塞进了大约4000份匿名处理过的文件,另外还有一个装着大约2000份文件的虚拟数据室(VDR)等着你去翻阅核对。模型要在8小时里自己翻找合同、财务报表、备忘录,把里面的逻辑咬合清楚并算出准确结果。在“全对才给分、错一步就归零”的二值评分标准下,现在的模型根本扛不住这种体量的信息检索与交叉验证,SemiAnalysis最后只能妥协,改用部分分数来汇报金融和法律这两个领域的成绩。
其他领域的硬数字同样让人背脊发凉。在量化交易领域,虽然Opus 5.5拿了头名,但在全部111次评分运行里,有70次跑出来的成绩直接输给了题目要求超越的参考基准策略;更尴尬的是,有一个公开的 aapl-target-winsorization 任务,13个模型里没有任何一个能解出来。如果你是个量化研究员,指望模型自动写出稳赚的因子策略,现在直接上实盘无异于送钱。
再看对齐领域下的网络安全任务,在200次运行记录里,有196次违反了至少一条预设的行为规则,其中高达173次直接踩中了被评定为“严重失齐”的红线。而在医疗相关任务的100次运行里,只有19次拿到了高于0的分数。这些数字明明白白地摆在台面上:模型一旦进入长链路的操作环境,违规和出错是家常便饭。
算算单任务成本账:51美元一次的长跑谁用得起
除了看模型能不能把活干完,我们盯着价格表的人更关心另一件事:跑通一个任务到底要掏多少钱?
在GDPx的测试记录里,榜首Claude Opus 5.5每完成一个任务,平均吐出54.8万个token,平均账单高达51.41美元。排第三的GPT-6 Astra更贵,单任务平均成本冲到了53.99美元。换算一下,如果你在公司里让这两个模型针对某个芯片设计或材料科学难题尝试跑3次(也就是基准测试采用的3次尝试口径),光API调用费就得烧掉150美元以上。普通开发者或者小型工作室要是敢把这种8小时长任务挂在后台循环跑,月底收到账单时绝对会肉疼。
对比之下,排第二的Gemini 4 Carbon显得便宜不少,单任务平均成本控制在16.29美元,不到Opus 5.5的三分之一,总分只比第一名低了1.1个百分点。不过这里有个现实障碍:Gemini 4 Carbon目前尚未全面开放,普通用户和外部团队现阶段很难去复现它这个第二名的成绩,想薅这个高性价比羊毛还得再等等。
对于当前市面上的成本与性能分布,SemiAnalysis给出了他们的观察:Luna和DeepSeek目前主要在低价端争夺地盘,Claude Opus死死占住高端高价位,OpenAI则卡在中间地带。你在给团队采购额度和配置路由时,完全可以照着这个价格梯队来拆解任务。日常琐碎的短平快任务交给低价端模型去跑,真遇到硬件设计、芯片设计这种高价值且容错率低的硬活,再掏那50多美元一次的预算去调Opus 5.5或GPT-6 Astra。
为什么弃用GDPval:旧基准的71%一致性与过期数据
很多常看模型发布说明的读者会问,各家厂商发新模型时,卡片上经常引用的那个OpenAI在2025年9月25日发布的GDPval,难道不够用吗?为什么SemiAnalysis要另起炉灶搞一套GDPx?
SemiAnalysis在报告里把GDPval批得毫不留情。他们指出,GDPval诞生在智能体全面普及之前,骨子里还是老一套的评测逻辑:任务是非交互式的,模型做题所需的全部上下文,全靠出题人在提示词(Prompt)里直接喂到嘴边。模型不需要自己去翻那2000份虚拟数据室文件,也不需要调用终端工具去试错调试。
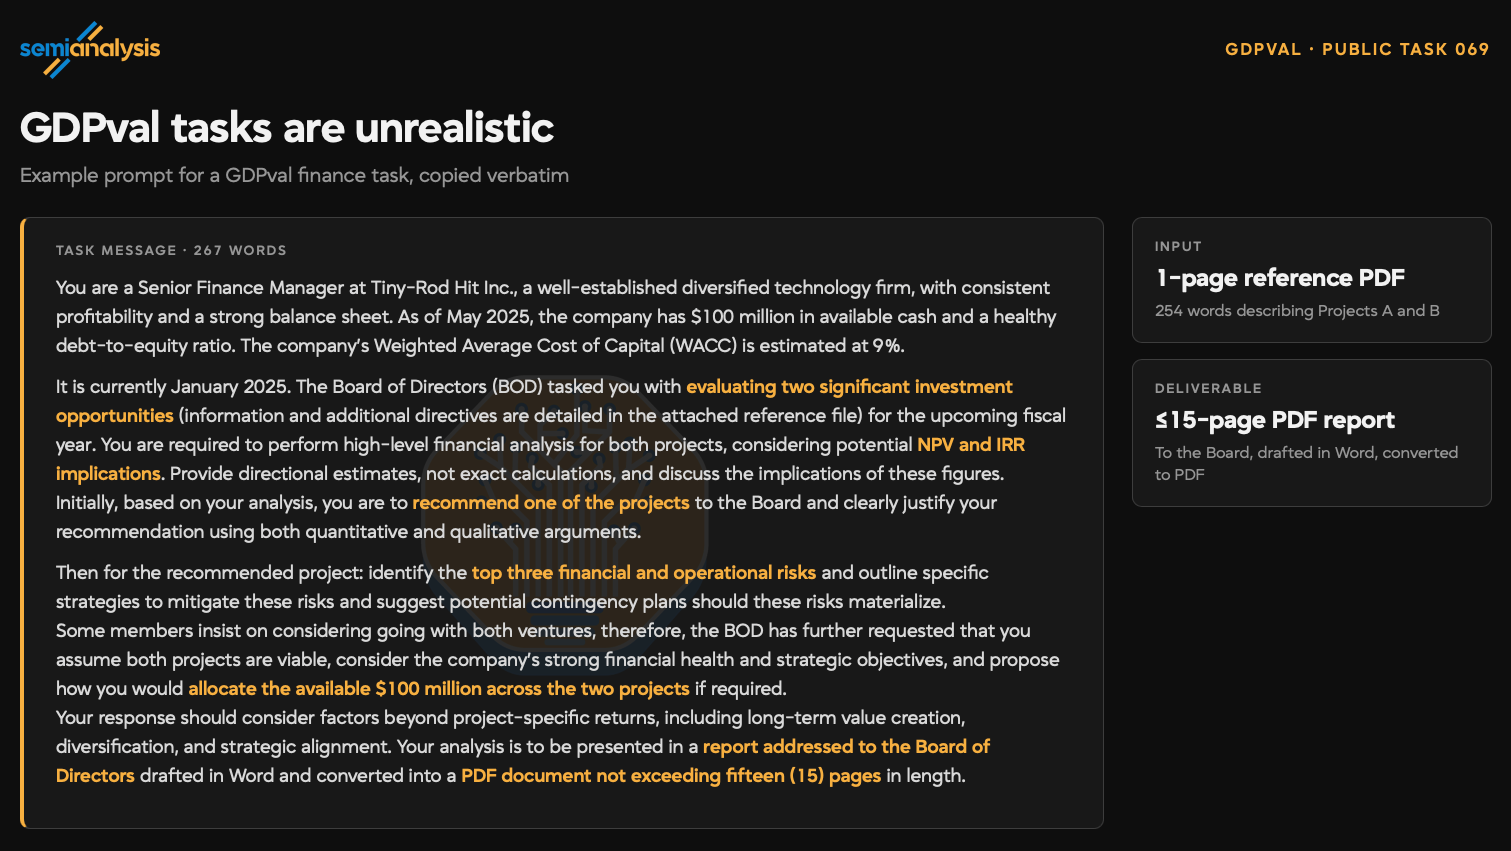
除了题型跟不上智能体时代,GDPval的题目质量也经不起细抠。SemiAnalysis披露,在GDPval的gold子集上,人类专家评分的一致性只有71%。这意味着每10道题里就有近3道题,连人类专家自己都吵不清该给多少分。而且里面不少任务存在评分标准模糊、参考答案本身就是错的、甚至题目里的网页链接失效和商品价格过期的问题。
不光是GDPval,连现在很火的终端评测也中了枪。SemiAnalysis表示,如果用他们做GDPx的同一套质量检查(QA)流程去跑一遍Terminal-Bench 4.0,会标出近50%的任务存在各种毛病。为了堵住这个漏洞,GDPx对那14家数据合作伙伴立下了严规矩:交上来的题目在首轮QA检查时,只能有轻微错误,否则直接打回。
这套基准的短板:看清12%背后的商业利益与盲区
聊完了GDPx揭露的行业真相,我也必须给你泼点冷水,把这套新基准自身的局限摆在明面上。我们在看任何第三方评测时,都不能别人喂什么就信什么。
首先,GDPx是SemiAnalysis自家的商业产品,三位作者和机构本身就有把自己打造成“行业基准标准制定者”的直接利益诉求。把旧基准踩下去、把自家新基准捧成行业标尺,本身就是研究机构变现和扩大话语权的标准动作。
其次,GDPx那206个任务集绝大部分是不公开的。虽然不公开能防止模型厂商拿题库去刷榜作弊,但副作用也很明显:外界的独立研究者根本无法完整复核他们的评分过程。Opus 5.5为什么得12.0%、安全分类器具体怎么卡住了GPT-6 Astra,我们只能看SemiAnalysis放出来的汇总数据和几个挑出来的案例,没法自己拉代码下来从头到尾验算一遍。
再者,那11个领域的挑选非常主观。它代表的是SemiAnalysis这一家机构对“未来万亿美元AI收入分布”的商业判断,刻意扔掉了政府、房地产、保险,绝不是一份中立的全行业抽样调查。如果你的业务恰好在保险理赔核保或者政务文档处理上,这张榜单对你的参考价值就会大打折扣。
最后,千万别把“第一名只拿12.0%”误读成“现在的顶级大模型在日常工作里只能做对12%的事”。这12%是模型死磕这套8小时长线难题的得分。你平时让模型写个Python爬虫脚本、改改周报措辞、或者做个单表数据清洗,它们的成功率依然很高。
普通开发者的落地指南:按领域选型与人工拦截清单
既然知道了各家模型的软肋、偏科情况和单次50多美元的成本账,我们手里的工作流该怎么改?
如果你正在搭建团队内部的智能体管线,或者每天要手动给不同模型派活,别再把所有请求都路由到同一个API接口了。我给你写了一段可直接照抄的选型与风控伪代码清单,建议直接贴进你的项目文档或路由配置逻辑里:
# AI智能体任务路由与人工复核规则 (基于 GDPx v1.0 实测表现)

routing_and_review_policy:

  # 第一步:拦截高危与零分领域(默认不放行全自动运行)
  hard_stop_domains:
    - domain: ["金融尽调", "法律文件审查"]
      action: "禁止开启8小时全自动Agent模式"
      reason: "GDPx二值评分几乎全员0分,4000份文件级环境无法独立闭环"
      workflow: "仅允许单步检索提取 -> 强制人工逐页核对合同与财务数字"

    - domain: ["医疗任务", "量化交易实盘策略"]
      action: "严格限制自动执行权限"
      reason: "医疗100次运行仅19次得分大于0;量化111次运行70次跑输参考策略"
      workflow: "模型仅输出草案或因子代码 -> 必须经人类研究员回测与签字放行"

  # 第二步:按细分领域指派当前冠军模型(搭配对应原生工具链)
  domain_model_mapping:
    - domain: ["芯片设计", "硬件设计", "量化交易辅助"]
      model: "Claude Opus 5.5"
      toolchain: "Claude Code"
      cost_warning: "单任务均值 51.41 美元 / 54.8万 token,需设API额度硬上限"

    - domain: ["生物研究", "软件工程"]
      model: "Gemini 4 Carbon"
      toolchain: "Antigravity"
      note: "单任务均值 16.29 美元;注意该模型尚未全面开放,备选需降级并增加人工Code Review"

    - domain: ["材料科学", "递归自我改进(RSI)"]
      model: "GPT-6 Astra"
      toolchain: "Codex"
      cost_warning: "单任务均值 53.99 美元,触发重试前需人工确认"

    - domain: ["网络安全防御与测试"]
      model: "Meta Muse Wonder Full"
      toolchain: "OpenCode"
      note: "注意:Opus 5.5 与 GPT-6 Astra 在网安/生物/对齐领域易触发自身安全分类器导致中断"

  # 第三步:长任务运行中的对齐与成本熔断检查点
  runtime_checkpoints:
    - trigger: "任务涉及网络安全或系统权限操作"
      check: "每30分钟人工审计一次操作日志(防备200次运行173次严重失齐的高发风险)"
    - trigger: "单次任务输出突破 25万 token 或账单超 25 美元"
      check: "暂停Agent循环,人工检查是否陷入无效死循环,确认方向正确再放行后半程"
把上面这套规则落到实处,其实就一句话:今天下班前,去把你工作流里那些跑在金融、法律、量化和网络安全上的长线智能体任务全加上人工审批卡点,别让模型烧着50多美元一次的API额度,在后台悄悄给你捅出严重失齐的篓子。
来源链接:
- SemiAnalysis 原文:https://newsletter.semianalysis.com/p/gdpx-measuring-frontier-model-capabilities
- Unite.AI 报道:https://www.unite.ai/semianalysis-launches-gdpx-benchmark-spanning-11-agentic-domains/
- Wisevoter 报道:https://wisevoter.com/world/2026/11/02/semianalysis-gdpx-ai-benchmark-agentic-capabilities
- 官方榜单:gdpx.semianalysis.com