 Grok
输出0美元、一次请求塞进1000个问题:连一个字都不写的Gemini Decision 1,凭什么单开一个API?
输入每百万token仅收0.10美元,端到端延迟压到150毫秒,我把Google刚发的决策专用接口扒了一遍。
先说结论。如果你手头的智能体每天都在调大模型干“是或否”、“几选一”、“从低到高打分”这种活,你过去一大半的API预算和等待时间都白交了。2026年11月11日,Google DeepMind产品经理Min Choi和首席科学家Felix Yu在官方博客放出了一个新端点Gemini Decisions API,底座模型叫Gemini Decision 1(模型名gemini-decision-1)。
这玩意儿一个字都不写。它把最高256K tokens的多模态上下文吃进去,单次请求最多同时回答1,000个独立问题,端到端延迟压在150到250毫秒,输入每百万token收0.10美元,输出收0美元。不过你也别急着把它当成全场最便宜的银弹,第三方算下来它在每百万任务成本上比对手Jev 1.14贵了一倍多,什么时候该换、什么时候别碰,咱们把账本摊开来算。
多数人把大模型当打字机用,账单就是这么爆掉的
咱们平时写代码搭工作流,习惯把所有任务都塞给聊天补全接口。用户发来一段客服录音或者一张报销单,你想检查里面有没有违规词、属于哪个业务线、紧急程度打几分,常规做法是什么?写一串长长的提示词,要求模型输出严格符合JSON Schema的字符串,还得在代码里写正则和异常捕获,防止它哪天抽风少打一个右括号。
你仔细想一下这个过程有多荒谬。你心里只要一个布尔值,或者从五个分类里挑一个,以及一个0到1之间的数字。为了拿到这几个比特的信息,自回归语言模型得老老实实跑解码循环,一个token接一个token地往外蹦:{、"、r、e、s、u、l、t、"、:、t、r、u、e、}。遇到带推理模式的模型更吓人,它在吐出那个true之前,先在后台吭哧吭哧写上几百个思考token,最后全算进最贵的输出账单里。
生成文本在决策类任务里纯属浪费。业务代码真正需要的东西只有两个:候选答案的概率分布,以及模型对当前判断的置信度。
Gemini Decision 1直接把文本生成这一步砍掉了。它不做逐token解码,拿到你的输入和问题列表后,只跑单次前向传播(single forward pass),直接给各个候选分支算分,返回归一化之后的概率和0到1之间的置信度分数。
砍掉生成循环之后,速度发生了质变。官方公布的数据里,模型计算的中位耗时只有50到100毫秒,算上网络传输的端到端延迟落在150到250毫秒之间。更离谱的地方在于并发评估能力:因为底层走单次前向传播,你在同一个请求里塞1个问题,和塞100个问题,端到端延迟几乎没有变化。上限能塞多少?单次请求最多1,000个独立问题。
咱们拿Google自家的内部业务来看看这几十毫秒能干嘛。Gemini Notebook已经把这套接口用在了实时路由上,用户发来一句话,路由层瞬间判断这是日常闲聊还是复杂任务,日常查询直接分流给轻量模型,复杂任务才留给深度推理模型,这么一改,日常查询的延迟最多降了40%。Google Search用它给MCP工具做安全层,实时拦截对抗行为;Google Labs里的CC拿它从200多个表情里挑出最贴切的反应;还有Stitch的快速画布实验,靠它在几秒钟内生成可玩的产品流程线框。这些场景有个共同点:高频、卡脖子、容不下大模型慢吞吞地吐字。
三种结构化题型,把判断逻辑塞进一次调用
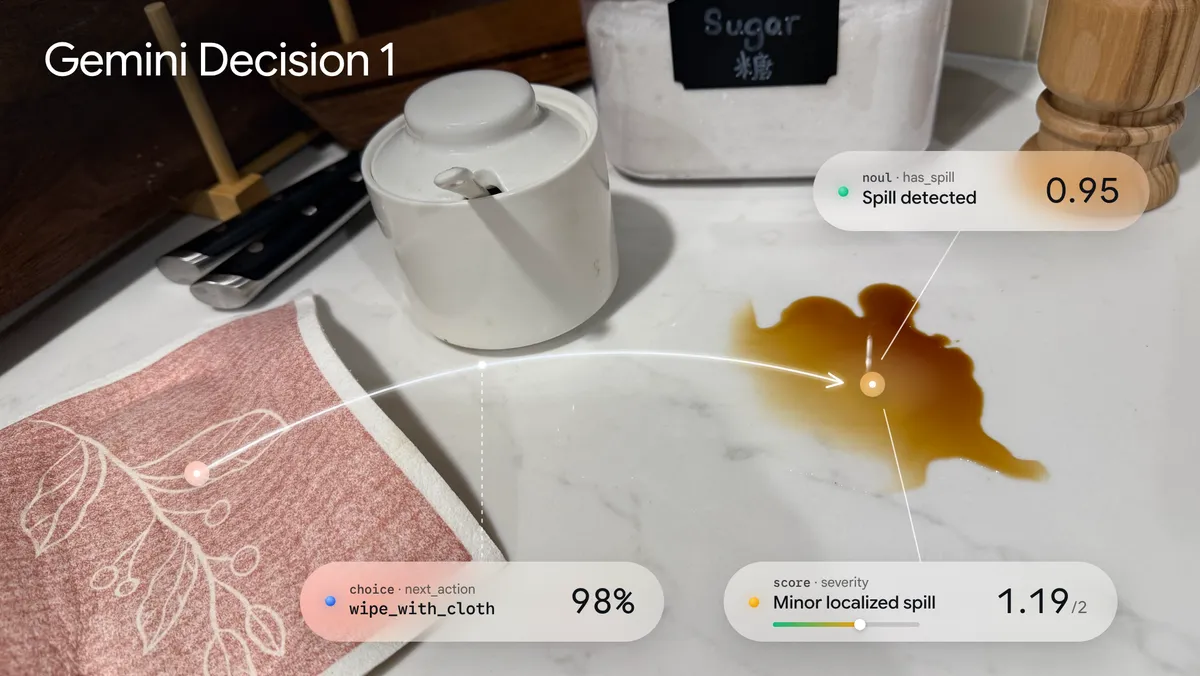
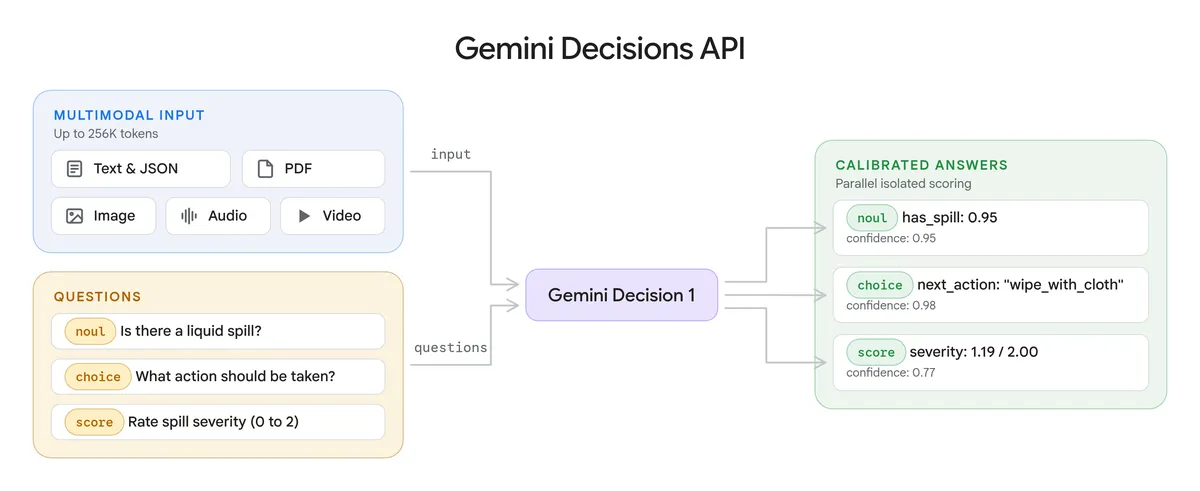
既然不吐字了,返回长什么样?通过Google AI Studio提供的Gemini API(目前在v1beta版本下),gemini-decision-1把人类所有的决策需求收敛成了三种固定的问题类型:noul、choice和score。
每次发请求,你传1个多模态共享输入,支持文本、图片、音频、视频、PDF,总容量上限为256K tokens。紧接着在这个共享输入后面挂载你的问题字典。
第一种叫noul,专门干“是或否”的二元判断。你可以只给一句指令,也能额外附上true和false的具体判定标准说明,模型直接告诉你判断结果和概率,省去了你自己在提示词里纠结“请回答Yes或No,不要回答其他内容”的麻烦。
第二种叫choice,也就是多选题。选项数量限制在2到255个之间(刚好印证了前面Google Labs的CC从200多个表情里挑反应的用法)。模型跑完后,除了直接给出胜出项,还会把每一个候选选项的归一化概率全列出来。你在写路由代码时,如果看到第一名概率0.51、第二名0.49,就能立刻在代码里触发兜底逻辑,或者把两个分支同时拉起来跑,再也不用对着一个干巴巴的字符串瞎猜模型到底有多大把握。
第三种叫score,做从0开始的有序打分。你按顺序给出一组档位描述,比如第0档干净、第1档小脏乱、第2档严重隐患,模型会返回每一档对应的概率,同时给你算好一个连续加权分数。做内容风控、工单定级或者检索重排序的时候,这个连续加权分可以直接拿去按阈值截断或者由高到低排座次。
动手跑通代码:从官方茶水间巡检到国内工单风控
光讲参数太干,咱们直接看代码怎么写。目前google-genai的Python SDK已经支持这个端点,OpenRouter、LangChain、Vercel、LiteLLM、Pydantic AI、Pipecat、LiveKit和OpenCode这些主流框架与网关也正在接入中,Google Cloud企业侧的支持则标着“即将推出”。
跑代码前得盯紧一个细节:这个接口目前放在v1beta版本里,初始化客户端的时候必须显式传入http_options={"api_version": "v1beta"},漏掉这句直接报错找不到方法。
先看官方给的茶水间巡检示例。场景很简单:早上9点客户来开会前,拍一张茶水间照片spill.jpg传上去,连带一句背景说明,一口气让模型把“有没有洒漏”、“该派谁去处理”、“脏乱程度打几分”全干完。我把官方代码里的注释和说明全部改写成了中文,你装好最新版的google-genai就能直接套用:
from google import genai

# 注意:目前必须指定 v1beta 版本才能调用 decisions 端点
client = genai.Client(http_options={"api_version": "v1beta"})

response = client.decisions.create(
    model="gemini-decision-1",
    # 图片 + 文本一起作为共享多模态输入(上限 256K tokens)
    input=[{
            "type": "image",
            "uri": "https://storage.googleapis.com/generativeai-downloads/images/spill.jpg",
            "mime_type": "image/jpeg",
        },
        {
            "type": "text",
            "text": "9 点客户会议前的茶水间检查",
        },
    ],
    questions={
        # 题型 1:noul(是/否二元判断)
        "has_spill": {
            "type": "noul",
            "instructions": "台面上有没有没清理的液体洒漏?"
        },
        # 题型 2:choice(多选,支持 2 到 255 个选项,返回胜出项与归一化概率)
        "next_action": {
            "type": "choice",
            "instructions": "哪种清理动作合适?",
            "criteria": {
                "wipe_with_cloth": "台面小洒漏,附近有布",
                "dispatch_janitorial": "地面大面积隐患、碎玻璃或正在漏水",
                "ready_for_meeting": "台面干净,可以开会"
            }
        },
        # 题型 3:score(从 0 起的有序打分,返回连续加权分数与每档概率)
        "severity": {
            "type": "score",
            "instructions": "给台面脏乱程度打分",
            "criteria": [
                "干净就绪",
                "局部小洒漏",
                "严重洒漏或安全隐患"
            ]
        }
    }
)

print(response)
看明白这个结构之后,咱们很容易就能把它平移到国内开发者每天都在写的售后工单合规与路由系统里。假设你接了电商或者SaaS后台的客服对话,每次用户发来一段通话录音、一张报错截图外加聊天记录(加起来几千个token),你原本要串行调好几个小模型或者写个巨型Prompt去做合规质检、部门分流和情绪评级。现在直接合并成一次调用:
from google import genai

# 同样锁死 v1beta
client = genai.Client(http_options={"api_version": "v1beta"})

# 假设这是拼接好的长工单文本(也可以直接塞入音频文件或 PDF 附件)
ticket_context = """
【工单记录】客户反馈订单扣款成功但后台一直显示待支付,已持续两小时。
沟通中客服人员出现不耐烦语气,未按规定提供工单编号,客户提到要去监管部门投诉。
"""

# 一次前向传播,同时完成合规检查、路由分流与风险打分
ticket_check = client.decisions.create(
    model="gemini-decision-1",
    input=[ticket_context],
    questions={
        # 二元合规检查:可附带 true/false 描述标准
        "has_compliance_risk": {
            "type": "noul",
            "instructions": "客服沟通过程是否存在违规或引发投诉的风险?",
            "criteria": {
                "true": "客服态度恶劣、未按流程给编号,或客户明确提及外部投诉",
                "false": "客服正常安抚并按标准流程处理问题"
            }
        },
        # 智能体/工单路由:从候选队列中挑出最匹配的接手部门
        "route_department": {
            "type": "choice",
            "instructions": "这张工单应该立刻转交给哪个组?",
            "criteria": {
                "payment_tech_support": "涉及扣款状态不同步、支付网关异常等技术故障",
                "vip_crisis_team": "客户情绪失控、明确提出监管投诉的升级工单",
                "general_faq_bot": "常规退换货咨询或物流单号查询"
            }
        },
        # 紧急度连续打分:0 档最低,往上递增
        "urgency_level": {
            "type": "score",
            "instructions": "评估该工单的紧急处理等级",
            "criteria": [
                "常规咨询,可按正常队列排队",
                "资金显示异常,需在 30 分钟内人工介入",
                "高危投诉叠加资金异常,需主管立即接管"
            ]
        }
    }
)

print(ticket_check)你注意看上面这段代码。不管你在questions字典里写3道题、20道题还是500道题,ticket_context这段占大头的上下文只传一次。这就引出了整篇文章最实在的部分:你的账单到底能省下多少钱?
扒开账本算细账:便宜近5倍是怎么算出来的,谁比它还便宜?
咱们先把Gemini Decision 1的官方价目表钉死:
- 输入价格:每百万token收0.10美元。
- 输出价格:0美元。因为它根本没有输出token。
- 附加费用:没有思考token账单,传音频不收单独的语音转写费,传图片和PDF也不收单独的OCR费用。Google AI Studio里还留了免费层供大家做原型验证。
- 计费规则:共享输入在每个请求里只计费一次,后面挂着的每道题,只按那道题自己的指令(instructions)和标准(criteria)token累加计费。
最后这一条规则,直接决定了批量检查场景的生死。咱们直接拿VentureBeat根据Google定价页算出来的一笔账来对一对。
假设你手头有一批业务记录,每条记录长4,000个token。合规部门给你列了20项检查清单,每道检查题的指令加判定标准占50个token。
如果你用上了Gemini Decision 1的共享输入机制,把1条4,000 token的记录和20道题(20 × 50 = 1,000 token)打包进一次请求,这单请求的总输入就是5,000个token。按每百万token 0.10美元算,跑完1,000条记录(总计500万token),你的账单大概只有0.50美元。
反过来,要是你按老办法,20道检查题分20次调用去跑,每次都得把那4,000 token的记录重新发一遍,哪怕不算JSON解析失败导致的重试开销,跑完1,000条记录的成本也得飙到约8.10美元。0.50美元对8.10美元,差出去十六倍还不止,省下的钱全来自“共享输入只收一次钱”和“0输出费用”。
但咱们做技术选型的不能光听官方挑好听的讲。Google在博客里放出了一组对比:说在自家的基准测试上,Gemini Decision 1在智能体路由、推理、排序和多模态理解方面领先,而且校准误差最低;跟自家的Gemini 3.5 Flash-Lite配合Interactions API相比,在共享基准套件上便宜近5倍。
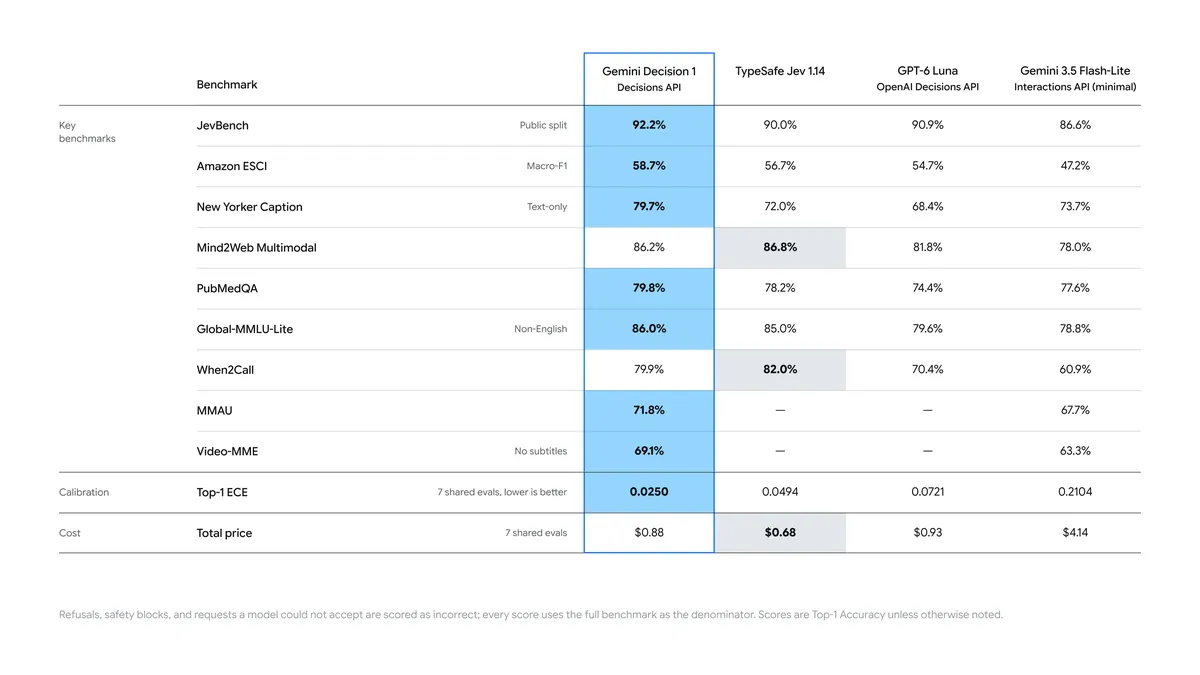
注意了,上面这句“便宜近5倍”,是Google拿Decision 1跟自家的Gemini 3.5 Flash-Lite比出来的,而且这些领先说法属于Google自家口径,未经独立验证。要是把它拉到整个行业的决策模型牌桌上,真实排位和价格长什么样?我把VentureBeat转引的Google测试数据以及第三方平台orcarouter.ai的测算汇总成了下面这张表:
| 对比维度 | Gemini Decision 1 (`gemini-decision-1`) | Jev 1.14 | Gemini 3.5 Flash-Lite (+ Interactions API) | 数据与口径来源 |
|---|---|---|---|---|
| 计费模式 | 输入 $0.10 / 百万 token,输出 $0 | 专用决策模型计费 | 常规生成式输入/输出计费 | Google 官方博客 |
| 端到端延迟 | 150 - 250 毫秒(模型计算中位数 50 - 100 毫秒) | 未在同表披露 | 受生成 token 长度影响 | Google 官方博客 |
| Artificial Analysis 决策指数 | 66 分(18 个决策模型中排第 9) | 未在同表单列分数 | 未在同表单列分数 | orcarouter.ai |
| 7 项共享基准测试胜率 | Google 称在 7 项测试里有 5 项领先 Jev 1.14 | 7 项中赢下其余项 | 对照组 | Google 官方 / VentureBeat |
| 同一套共享测试总成本 | 0.88 美元 | 0.68 美元 | 4.14 美元 | VentureBeat 转引 Google 数据 |
| 每百万任务估算成本 | 约 345 美元 | 约 156 美元 | 未单列(按比例远高于前两者) | orcarouter.ai |
| 1000 条记录 × 20 道检查 | 约 0.50 美元(一次打包请求) | 未单列 | 未单列 | VentureBeat 按 Google 定价页测算 |
补充一句口径:VentureBeat 还按同一份定价页算过,同样 20 道检查如果分 20 次调用、每次重发 4,000 token 记录,每 1,000 条记录要花约 8.10 美元(同按每百万 token 0.10 美元),是打包请求的 16 倍多。这笔账跟 Flash-Lite 无关,纯粹是"重发上下文"这个动作本身贵。
看这张表,真相就清楚多了。
第一,Google喊出的“便宜近5倍”,对应的是表里共享测试成本从Gemini 3.5 Flash-Lite的4.14美元降到了Decision 1的0.88美元(4.14 ÷ 0.88 ≈ 4.7倍)。如果你之前一直在用Flash-Lite这种轻量生成模型硬扛分类和打分,换过来确实能砍掉将近五分之四的开销。
第二,它绝对算不上全场最便宜的决策模型。在完全相同的共享测试套件下,竞争对手Jev 1.14只花了0.68美元,比Decision 1的0.88美元还要便宜。如果按orcarouter.ai折算的每百万任务成本来看,Decision 1大约要花345美元,而Jev大约只要156美元,价格差了一倍多。
第三,在Artificial Analysis Decision Index(决策指数)榜单上,Gemini Decision 1拿到了66分,在参评的18个决策模型里排在第9位,处于中游位置。虽然Google称它在7项共享测试里有5项赢过了Jev 1.14,但如果你手头只是纯文本的简单高频分类,去接Jev这类更便宜的对手,账面上会更划算;Gemini Decision 1真正的杀手锏在于它能直接吞下最高256K的音频、视频、PDF和图片,免掉OCR和语音转写费,还能在一个请求里塞1,000个问题而不怎么增加延迟。
现在就切过去?先看清这几个上线初期的坑
如果你看完上面的算账,觉得自己的多模态审核或者智能体路由正好撞在它的甜点区上,准备今天就把线上代码改了,先踩一脚刹车。
据orcarouter.ai报道(注:以下限制来自第三方分析,Google官方博客尚未逐条确认),gemini-decision-1在上线初期还有几个挺扎手的工程限制:
先说调用通道。目前这个模型只走Gemini Developer API的v1beta端点(也就是Google AI Studio那条线),企业级生产环境最常用的Vertex AI里还没有上线。如果你的公司安全合规要求所有流量必须走Google Cloud的Vertex AI内网协议,现在只能等那个“即将推出”落地。
再看缓存和批量:它目前不支持Prompt Caching(提示词缓存),也不支持Batch API(批量异步接口)。这意味着什么?前面我们算过,同一个请求里挂100个问题,4,000 token的上下文只收一次钱;但如果你是跨请求调用,比如你有一本200K token的产品手册,想对每天实时涌入的10,000条用户提问分别做路由判断,由于没有Prompt Caching,你没法把那200K的手册缓存起来跨请求复用,每次新请求进来都得重新按每百万token 0.10美元交一遍过路费。
还有免费层的隐私问题。据报道,Google AI Studio免费层跑过的数据会被拿去改进产品。平时自己写个脚本拿茶水间照片做原型验证随便造,但凡涉及到公司内部工单、客户录音或者未公开的业务文档,千万别贪免费层的便宜,老老实实绑卡走付费通道。
顺带提醒:用Claude写代码的,记得在12月10日前去领一次免费全量额度重置
聊完Google的新接口,文末顺手给各位每天盯着用量条的开发者带个信。根据2026年11月10日Anthropic开发者官方账号@ClaudeDevs在X上发的帖子(多家媒体已转引确认),Claude目前正在给所有Pro、Max、Ultra和Team订阅用户发放一次免费的全量额度重置。
为什么突然发福利?Anthropic承认近期系统出了几个小问题,导致部分用户被多扣了额度;而且之前针对Fable 5.2做过一次重置,但那次操作对已经把周额度打满的人来说基本没起作用,所以这次干脆给所有人补发一张手动重置券。
领取的截止时间定在2026年12月10日14:00(太平洋时间)。你可以直接打开Claude后台的Settings > Usage页面,或者在浏览器里敲clau.de/reset去点领取。动手前看清四条规矩:这次操作只恢复你当前周期已经消耗掉的额度,不会提高你的总额度上限;点下按钮立刻生效且不能撤销;如果你在领取前降级或者取消了订阅,资格会直接失效。建议挑你这周写代码最猛、刚好把周限额刷见底的那天再去点,别在额度还剩一大半的时候白白浪费掉。
回到今天的主角。把生成文本的执念放下,把原本拆成几十次的JSON提问塞进单次150毫秒的前向传播里,这大概就是今年底你给智能体降本提速最立竿见影的一刀。
来源:
- Google DeepMind 官方博客:https://blog.google/innovation-and-ai/technology/developers-tools/gemini-decisions-api/
- VentureBeat:https://venturebeat.com/technology/googles-gemini-decision-1-model-scores-up-to-1-000-questions-in-one-api-call
- orcarouter.ai 分析:https://www.orcarouter.ai/blog/gemini-decision-1-release-decision-index
- MLQ:https://mlq.ai/news/google-launches-gemini-decision-1-a-model-that-scores-up-to-1000-questions-in-one-pass/
- Claude 重置消息来源:https://x.com/ClaudeDevs/status/2120275296637321476