 Grok
15秒视频只要1.05美元?Gemini Omni 1.2 Flash 正式上线,算完多轮改稿账单我劝你先去白嫖
720p 视频每秒降至 0.07 美元、LMArena 双榜第一,但真正决定你账单数字的是多轮对话改稿的次数。
Google DeepMind 在 2026 年 11 月 5 日发布了 Gemini Omni 1.2 Flash。发布当天,Gemini API、Google Cloud、AI Studio、Google Vids、Flow 和 Gemini 应用同步上线,其中 Gemini 应用端采取分批推送。这也是谷歌 Omni 视频产品线第一次走完预览阶段、进入正式可用(GA)状态。
先说直接关系到你钱包和工作流的结论:单条视频生成上限从上一代的 10 秒拉长到了 15 秒,720p 视频输出单价从每秒 0.10 美元砍到了 0.07 美元,降幅 30%。大模型竞技场 LMArena 最新榜单里,它拿下了文生视频和图生视频两个第一。
很多人看到“15 秒 720p 视频只要 1.05 美元”的宣传就准备充钱调 API 了。先等一下。实际工作流里,吃掉你预算的往往是多轮对话修改的废片成本,而且大部分个人用户根本犯不着掏这笔 API 费用,因为谷歌在一个办公应用里留了每月免费生成 3 条 15 秒视频的口子。
多出来的 5 秒钟,到底能多干什么?
在此之前,Omni 1.1 Flash 的视频时长卡在 3 到 10 秒之间。做过短视频或信息流广告的人都有体会,10 秒是个挺尴尬的长度:拿来做空镜素材嫌贵,拿来做完整叙事又刚好差一口气,话还没说完画面就断了。
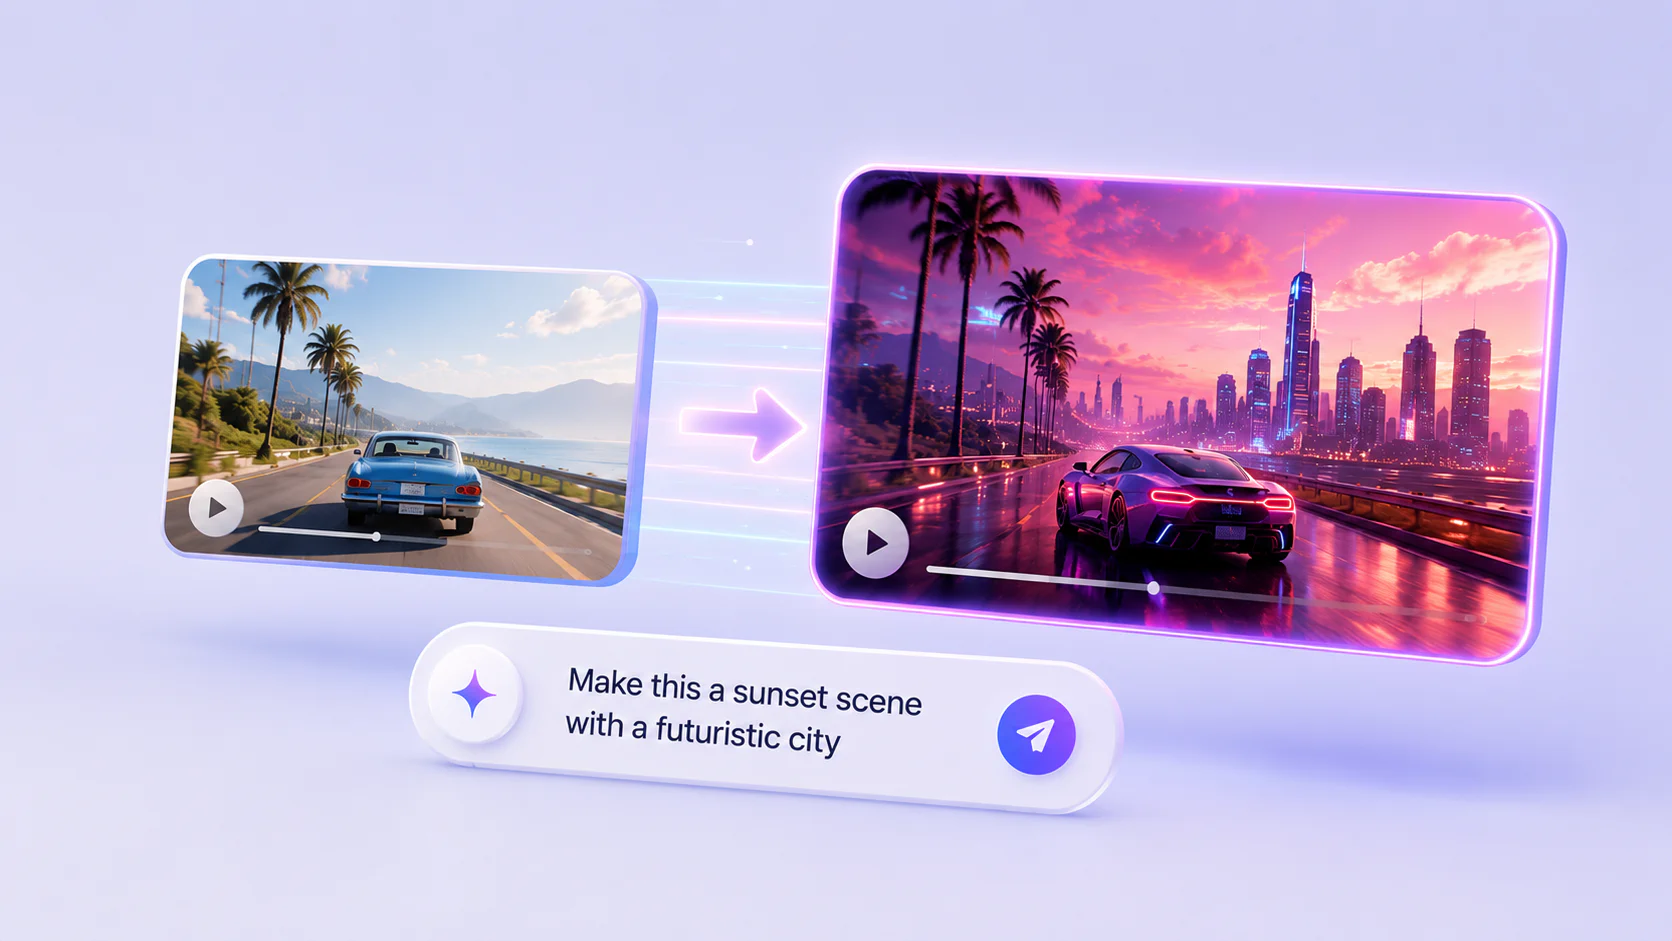
这次 Omni 1.2 Flash 把时长范围扩到了 3 到 15 秒,支持以 1 秒为步长自由调节。你可以精确要求生成 11 秒、13 秒或者满格 15 秒。多出来的这 5 秒,刚好够塞进一个完整的“起承转合”镜头,或者一条不带硬切的产品展示片段。
为了配合更长的单条时长,1.2 版本加入了多轮对话式编辑功能。大家以为 AI 做视频还是“抽卡模式”,第一次提示词没写对、画面里多了一只手或者灯光偏暗,就得改完提示词全部推倒重来;实际上,现在你可以直接跟模型对话,在第一版生成的视频基础上追加指令继续改,不用从头重跑。
另外,据 Google Cloud 公告,新模型对参考图的遵循能力变强了,你可以喂给它角色设定图或商品图来稳住画面特征。至于很多人关心的音频参考功能,目前还锁在白名单里,普通开发者暂时调不到。
顺带交代一下背景:不少人容易把 Omni 和谷歌自家的 Veo 搞混。Omni 是谷歌在 Veo 之外单独开辟的另一条视频产品线,定位是从任意模态创建和编辑视频。这条线走得很快,今年 6 月底 Omni Flash 刚在 Gemini API 开启公开预览,8 月底 Omni 1.1 Flash 就接棒上线,顺手取代了 Gemini API 里的 Veo 3.1 预览版。到了 11 月 5 日,模型 ID 为 gemini-omni-1.2-flash 的正式版直接推向全平台。
不过动手之前,你也得清楚它的短板。Google 官方自己承认,遇到快速体育动作、脚本快速切换、复杂物理场景时,模型表现依然吃力。至于官方宣传里提到的画面一致性、参考遵循度、口型同步效果变好,目前这几个说法只来自 Google 自己的公告,市面上还没有已公布的独立对照测试来验证,建议大家实际跑几条样片自己看。
每秒 0.07 美元只是表面数字,我们来算笔 10 条成片的真实账单
看一眼 Google 定价页(已经过多家媒体复核),Omni 1.2 Flash 的账面价格确实比上一代便宜了三成。
我把新旧版本及不同分辨率的计费标准整理成了下面这张表,方便你直接比对:
| 计费项目 | Omni 1.2 Flash | 备注 |
|---|---|---|
| 720p 视频输出 | 0.07 美元 / 秒 | 比 1.1 的 0.10 美元 / 秒便宜 30% |
| 360p 视频输出 | 约 0.023 美元 / 秒 | 15 秒草稿约 0.35 美元,适合先出小样 |
| 1080p 视频输出 | 约 0.104 美元 / 秒 | 15 秒单条约 1.56 美元 |
| 4K 视频输出 | 约 0.209 美元 / 秒 | 15 秒单条约 3.14 美元 |
| 15 秒 720p 单条总价 | 约 1.05 美元 | 按 Token 折算约 1.04 美元(720p 每秒 5792 Token,15 秒共 86880 Token,视频输出 12 美元 / 百万 Token) |
| 多模态输入(文本 / 图片 / 视频) | 1.50 美元 / 百万 Token | 提示词、参考图与待编辑视频都按这个收 |
| 文本输出(含思考 Token) | 9 美元 / 百万 Token | 模型返回的文本与推理过程计费 |
| Gemini API 免费层 | 不可用 | 定价页明确标注 Free Tier 不支持 |
看到这里,很多人会直接拿“1.05 美元乘以 10”,以为做 10 条 15 秒成片只要准备 10.5 美元就够了。实际上,真正掏空你钱包的是反复改稿的次数。
哪怕有了多轮对话编辑,模型每一次给你返回修改后的视频,都是在重新输出一条新视频,照样要按秒或者按输出 Token 扣费。而且多轮对话意味着你要把上一轮的视频和新的修改指令一起作为输入喂给模型,还要加上模型的思考 Token 消耗。
Google 官方在公告里给了一个挺实在的上手建议:先用 360p 或 720p 起草,挑中意的再放大到 1080p 或 4K。360p 每秒只要约 0.023 美元,一条 15 秒草稿的输出部分约 0.35 美元,抽卡试错先走 360p 能把草稿钱压到原来的三分之一。
我们就按实际干活的节奏,算一笔制作“10 条 15 秒 1080p 最终成片”的账:
假设你运气不错,每条片子先用 720p 抽卡和对话修改,平均改 3 轮(即生成 3 次 720p 草稿)定稿,最后输出 1 次 1080p 成片。
- 草稿阶段(720p):15 秒 × 0.07 美元/秒 = 1.05 美元/次。改 3 轮就是 3.15 美元。
- 成片放大(1080p):15 秒 × 0.104 美元/秒 = 1.56 美元/次。
- 输入与思考 Token:4 轮对话里传入的文本、参考图、上轮视频输入(1.50 美元/百万 Token)加上模型的文本与思考输出(9 美元/百万 Token),折算下来单条工作流大约零星消耗几美分。
这么算下来,搞定 1 条满意的 15 秒 1080p 视频,实际花费在 4.75 美元左右;做满 10 条成片,你的真实账单大概是 47.5 美元,如果最终要交付 4K 分辨率(单次 15 秒约 3.135 美元),10 条的总成本会奔着 63 美元 去,远不止宣传口径里的十来块钱。
当然,即便算上改稿成本,这个价格在同行里依然很能打。据智东西 11 月 6 日报道,在大模型竞技场 LMArena 上,Omni 1.2 Flash 在文生视频和图生视频两个榜单双双拿了第一,视频编辑榜排第三,排在它身后的对手包括 FLUX 3 Video、Grok Imagine Video 1.5、Seedance 2.0 以及 Seedance 2.5。同篇报道称,Omni 1.2 生成同等质量 720p 视频的价格,不到 Seedance 2.5 的三分之一。
如果你是开发者或企业团队,准备现在接入 API,可以直接参考下面这段调用示例。注意,所有生成的视频都会默认带上 SynthID 隐形水印,企业客户如果怕高并发卡顿,可以去申请 Provisioned Throughput(预留吞吐)。
import base64
from google import genai

# 初始化客户端:免费层不支持此模型,项目需绑定计费
client = genai.Client(api_key="YOUR_GEMINI_API_KEY")

# 第一轮:用 Interactions API 生成 15 秒 720p 视频(时长 3-15 秒)
interaction = client.interactions.create(
    model="gemini-omni-1.2-flash",
    input="生成一个15秒的产品展示镜头:一杯冰美式放在木桌上,阳光透过百叶窗移动。",
)
with open("draft.mp4", "wb") as f:
    f.write(base64.b64decode(interaction.output_video.data))

# 第二轮:同一 Interactions API 里用自然语言继续改,不用从头重来
interaction2 = client.interactions.create(
    model="gemini-omni-1.2-flash",
    input="保留刚才的镜头和光影,在第 8 秒加入一只手拿起咖啡杯的动作。",
)
with open("edit.mp4", "wb") as f:
    f.write(base64.b64decode(interaction2.output_video.data))
这里给老用户提个醒:如果你手头的项目还在调用旧模型 ID gemini-omni-1.1-flash,从 2026 年 12 月 3 日起,谷歌会自动把发往 1.1 的请求路由到 gemini-omni-1.2-flash,并且直接按 1.2 的新价格计费。趁着还有近一个月时间,最好主动去代码里把模型 ID 改过来,顺便检查一下时长参数。
普通人不用 API,怎么去 Google Vids 里白嫖?
看到 API 定价页上“Free Tier 不可用”那一行字,不想绑信用卡的个人用户先别关页面。大家以为新模型上线只有开发者掏钱才能用,实际上谷歌在自家的办公应用 Google Vids 里留了免费额度。
只要你有普通的 Google 个人账号,或者公司开通了 Workspace 订阅,现在打开 Google Vids,每个月都能免费生成最多 3 条 15 秒的视频。拿来给演示文稿做个片头、或者发两条社交平台素材,这 45 秒的免费高质量生成额度完全够应付日常临时需求了。
如果你手头本来就有谷歌的付费订阅,那能调动的视频秒数就宽裕得多了。我把 Google Vids 每月给不同账号档位分配的 AI 视频秒数额度列在下面,你可以对号入座查一下自己的账户余量:
- 个人免费账号与 Plus 档:每月 60 秒额度;另外,Google Vids 每个月还给免费 3 条 15 秒视频的机会。
- Pro 档订阅用户:每月 500 秒额度,折算下来够你生成 33 条满格的 15 秒视频。
- Ultra 档订阅用户(分两档):每月分别给到 2500 秒和 10000 秒额度。
除了网页端的 Google Vids,日常习惯用手机或网页版 Gemini 聊天的用户也能用上。目前 Gemini 应用里的 15 秒视频生成功能,正在向 AI Ultra 订阅用户分批推送。如果你已经订阅了 Ultra,这两天不妨打开应用试试能不能直接让它吐出一条 15 秒的片子。
顺带一提:同日登场的蚂蚁百灵 Ling-3.2-flash
就在谷歌更新视频产品线的后一天,国内多模态赛道也有新动作。据 IT 之家 11 月 6 日报道,蚂蚁百灵在 11 月 6 日发布了原生多模态模型 Ling-3.2-flash。这个模型总参数量达到 560B,激活参数 25B,支持 1M 上下文窗口。价格方面压得很低,API 输入每百万 Token 只要 0.30 美元,输出每百万 Token 为 0.90 美元,而且上线前两周直接限时免费开放;蚂蚁官方称,该模型在三项基准测试中的成绩超过了 Claude Opus 5。
回到谷歌这次的更新,如果你今天就像试试 15 秒视频生成到底稳不稳,先别急着去后台充值调 API,直接登录 Google Vids 把这个月那 3 条免费的 15 秒额度用掉再说。
消息来源与参考链接
- Google DeepMind 官方公告:https://deepmind.google/technologies/gemini/
- TechRepublic 报道:https://www.techrepublic.com/article/news-google-omni-1-2-flash-video/
- 智东西报道(富途转载):https://news.futunn.com/post/1003647383
- AI Briefing 每日简报:https://aibriefing.dev/story/3e93342c42d6/
- FoneArena 报道:https://www.fonearena.com/blog/496530/google-gemini-omni-1-2-flash.html