「不会说话的 AI」长出眼睛了:Liquid d1 决策模型支持看图,官方称比 GPT-6.1 Sol 便宜 200 倍
决策模型从只读文字到能看图:分类、分拣、质检这类活,可能再也不需要调用完整的语言模型了
「不会说话的 AI」长出眼睛了:Liquid d1 决策模型支持看图,官方称比 GPT-6.1 Sol 便宜 200 倍
结论先行:
- 发生了什么:MIT 衍生公司 Liquid AI 在 10 月 5 日官宣,其决策模型 d1 新增视觉能力,成为首个同时支持文本与图像的"决策模型"——它不写字、不聊天,只对你给定的选项输出校准概率。
- 为什么值得看:d1 的计费方式是"只收输入钱、输出永远 0 token"。Liquid 官方用 6 个真实应用把它和 GPT-6.1 Sol、Claude Opus 5.5 对打,称 d1 在其中 4 个上打平或更强,而成本低 19 到 200 倍,单次文本决策 200–300 毫秒。
- 赛道信号:这是继 TypeSafe Jev(本站 9 月介绍过)之后,决策模型赛道的第二个重磅玩家,而且已经有第三方拿它和 Jev 在公开预测基准 GJOpen 上做了独立对比。"分类、分拣、打分、审核"这类活,正在从通用大模型的领地里被切出来。
- 怎么用:已上线 Liquid API(模型名
d1)、官方 Playground、Vercel AI Gateway 与 OpenRouter(目前文本先行,视觉随后)。纯托管 API,没有可下载权重;官方表示后续模型计划在 Hugging Face 发布开放权重。 - 先泼冷水:性能与成本数字全部来自 Liquid 自家一次性的测试(方法学见文末),第三方独立复现还没有;如果你要的是写代码、写文章,d1 帮不上忙——它只回答"你定义的选项里选哪个"。
一、d1 到底是什么?一句话:只做选择题,不写作文
先给没看过本站 Jev 那篇的读者补个背景。过去一年,几乎所有"分类"工作都是这么干的:把工单/评论/图片丢给一个通用大模型,让它"用 JSON 格式回答是 A 还是 B"。模型吭哧吭哧生成一串 token,你为此付输出 token 的钱,还要写提示词逼它别跑题。
决策模型(decision model)把这条链路砍掉了:它不生成任何文本,直接返回每个选项的概率。比如"这条消息是投诉吗?"返回 0.999;"工单归哪类?"返回 billing 0.65、技术 0.30、账务 0.05。usage.output_tokens 恒为 0。
Liquid AI 的迁移指南把分工说得很直白:如果答案是 N 个已知选项之一,用决策模型;如果答案是一段需要现写的新字符串,继续用语言模型。
d1 的时间线很紧凑:9 月 29 日以实验版本亮相(据 MarkTechPost 等媒体报道),当时只支持文本,目标直指 TypeSafe 9 月 15 日发布的 Jev;10 月 5 日官方博客宣布 d1 支持图像,成为第一个把决策能力扩展到视觉的模型。
二、三种问题原语:Noul、Choice、Score
d1 把"做选择题"拆成三种题型,一次请求可以混着问,模型对同一份输入做一次前向推理就全部答完:
| 题型 | 问什么 | 返回什么 | 典型例子 |
|---|---|---|---|
| Noul | 是/否判断 | 0–1 之间的概率 | 这块电路板有缺陷吗?→ 0.92 |
| Choice | 多选一 | 每个标签的概率 + 置信度 | 工单分拣:billing 0.65 / technical 0.30 / account 0.05 |
| Score | 有序打分 | 概率加权的位置 | 紧急度 0–3 档 → 2.9995(几乎顶格) |
这套设计的精妙之处在于校准概率本身就是可用的工程信号:0.92 和 0.51 都是"是",但前者可以自动执行、后者应该转人工。传统 LLM 让你写提示词"顺便输出置信度",那个数字的校准质量一向堪忧;d1 把概率做成一等公民。
三、价格账:输出 token 永远免费,图也按输入算
这是 AI Price Memory 读者最关心的部分。d1 的计费只有一项:输入 token,$0.04 / 百万 tokens,输出 $0(Liquid 官方博客方法学注释与 OpenRouter 的 d1 页面一致)。图片按 32×32 像素块计 1.5 个 token,一张 1024×1024 的图折 1,536 个 token——和文字同价。
横向对比(均为官方挂牌价,不含缓存折扣):
| 模型 | 输入 / 百万 tokens | 输出 / 百万 tokens | 备注 |
|---|---|---|---|
| Liquid d1 | $0.04 | $0 | 决策专用;托管 API |
| GPT-6.1 Sol | $2 | $10 | OpenAI 次旗舰,主打性价比 |
| Claude Opus 5.5 | $4 | $20 | Anthropic 现任旗舰 |
算笔直观的账:150 张工单做一次"是否要退款"二分类,假设每单 200 token 输入、JSON 输出每单约 30 token。d1 成本约 $0.0012;GPT-6.1 Sol 约 $0.06 输入 + $0.045 输出 ≈ $0.1;Claude Opus 5.5 约 $0.22。同一件活,差出两个数量级。(示例估算,实际取决于 prompt 长度与输出格式。)
四、官方实测:6 个真实应用,打 GPT-6.1 Sol 和 Opus 5.5
Liquid 在 10 月 5 日用自家 Playground 的对比脚本跑了一组测试:d1 对 GPT-6.1 Sol 和 Claude Opus 5.5,6 个真实应用场景。官方结论:d1 在 4 个上打平或超过 Sol,成本低 19–200 倍,且每个任务都更快。
6 个应用分别是:
- Smart Filter:把 d1 写进 SQL 查询——
WHERE d1(ticket, 'the customer wants to cancel'),150 张客服工单逐条判"是/否"。 - Code Search:在 Hugging Face transformers 仓库(6,511 个文件)里逐层钻文件夹,找到能回答问题的那个函数。
- Smart Folders:新文档自动归档到文件夹/子文件夹,搜索问题同样先分类再检索,把关键词搜索范围缩小到一个子文件夹。
- Web Agent:给一句话目标,让 d1 在机票搜索网站上每一步从页面允许的全部操作里选下一个动作。
- Context Compaction:读 coding agent 会话里的每条工具输出,决定保留/裁剪/丢弃,删掉 52% 的 token,且任务必需的输出一条没丢——这对长会话 agent 的成本意义极大。
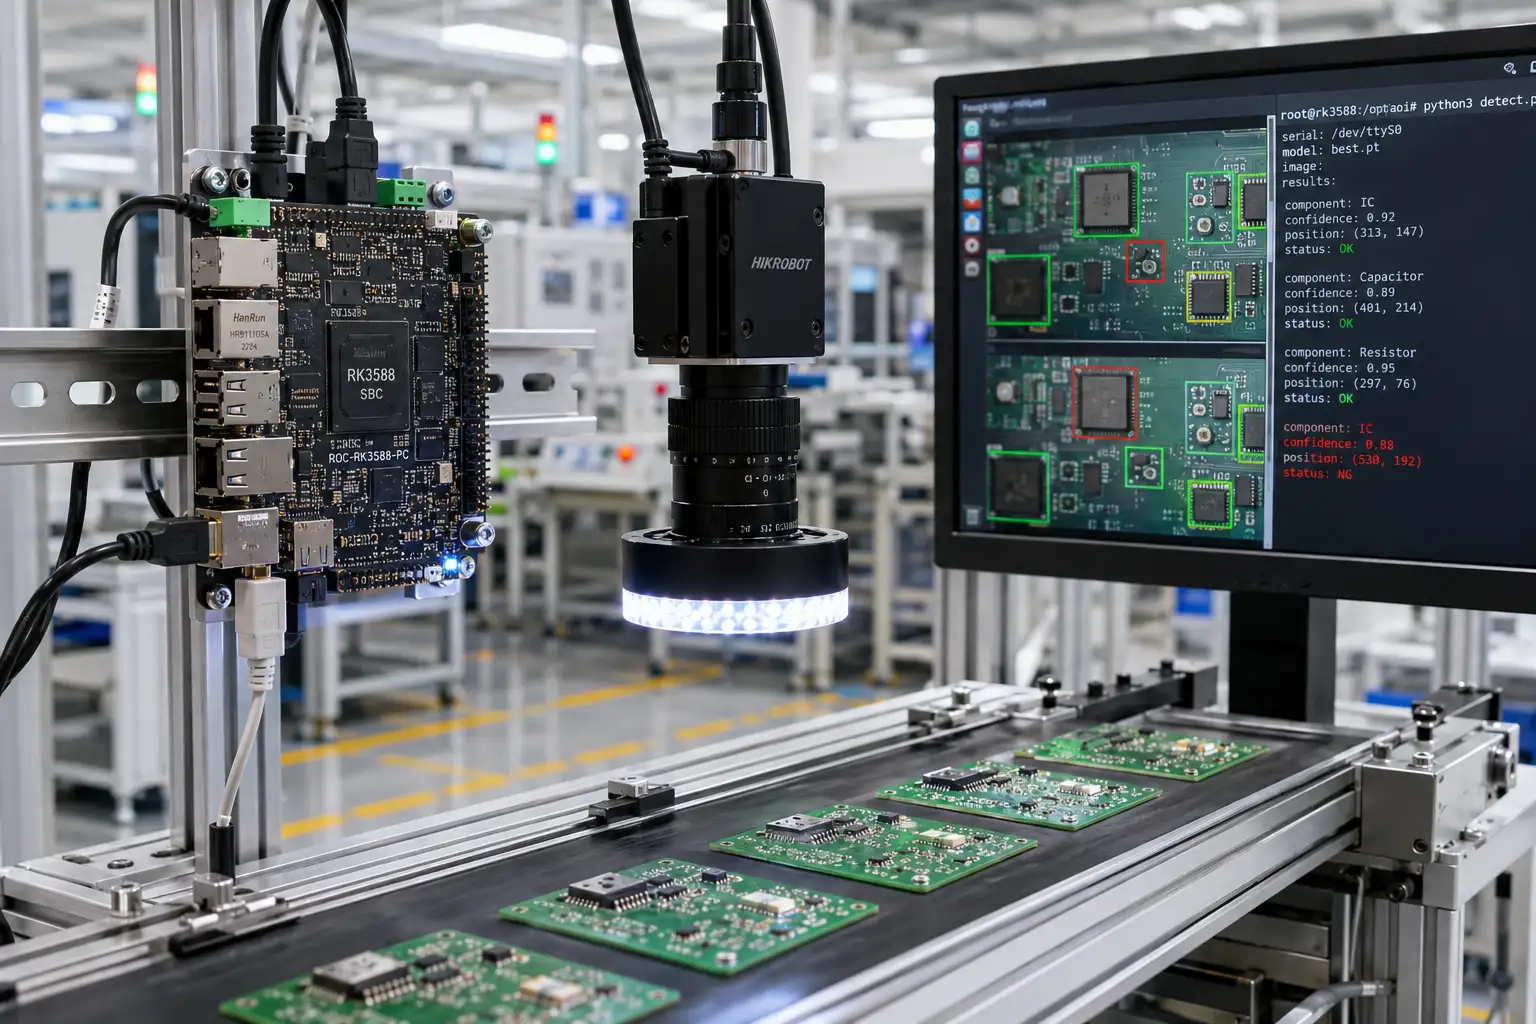
- Visual Inspection(视觉能力的主场):产线相机下的四类零件——电路板、蜡烛、腰果、口香糖(公开 VisA 数据集),d1 判良品/次品准确率 85–97%。关键是模型从没为这任务训练过,只靠一段文字描述就理解了要干什么。
还有一组好玩的游戏 demo,专门展示"眼睛"带来的增益:
- 俄罗斯方块:纯文字描述局面时清 70 行,加上屏幕截图后涨到 81 行;
- Wordle:直接读截图里的棋盘,不用开发者再写一份文字版游戏状态,12 局全胜、平均 3.8 猜;
- Quick, Draw!:62 个词里猜玩家的涂鸦,6 幅认对 5.2 幅(随机猜只能对 0.6 幅)。
五、独立视角:已经有人拿它和 Jev 正面对打了
d1 发布第二天,独立开发者 Utkarsh Ruhela 就在公开预测平台 GJOpen(Good Judgment Open,源自 Tetlock 的 Good Judgment Project)上做了 D1 vs Jev 的对比:用已解决的是非题考两家的概率校准。这类第三方对打的价值在于,厂商自测永远只展示自己赢的维度。
需要提醒两点:其一,这是回顾性测试(题目答案模型训练时可能见过),不是实时预测;其二,OpenRouter 的 token 量显示的是调用量而非独立用户数,别拿来比"谁更火"。但至少说明一件事:决策模型已经是一个值得独立评测的品类了,而不再是某家公司的营销概念。
另外两家媒体的交叉信息:datanorth 确认 d1 上下文窗口与 API 接入方式(Liquid API 与 Vercel AI Gateway);MarkTechPost 确认了实验版发布时间线与"纯托管、无 GGUF/MLX/ONNX 权重"的现状。各家口径一致,没有矛盾。
六、怎么上手:一次 POST 就行
d1 走的是 Liquid 自家的 System One API(注意:不是 OpenAI 兼容的 chat endpoint,OpenRouter 上它挂在 Decisions API 下,现有 chat SDK 不能直接套用):
import base64, os, requests

image = base64.b64encode(open("board.jpg", "rb").read()).decode()

response = requests.post(
    "https://api.liquid.ai/decisions/v1/systemone",
    headers={"Authorization": f"Bearer {os.environ['LIQUID_API_KEY']}"},
    json={
        "model": "d1",
        "images": [f"data:image/jpeg;base64,{image}"],
        "state": "Camera image of a circuit board on the production line.",
        "questions": {
            "defect": {
                "type": "noul",
                "instructions": "Does this circuit board have a defect?"
            }
        },
    },
)

print(response.json()["answers"]["defect"]["noul"])
上手路径有三条:去 console.liquid.ai 开 API Key(Dashboard > API Keys);先去 d1.liquid.ai 的 Playground 免代码试玩;或者走 Vercel AI Gateway / OpenRouter(目前只有文本,视觉随后上线)。官方还预告:正在做多个尺寸的后续决策模型,计划在 Hugging Face 发布开放权重——现在想自托管的可以先等等。
七、给 AI 模型用户的实在建议
先看你是不是目标用户。 你的工作流里如果有大量"从固定选项里选一个"的环节——工单分拣、内容审核、评论打标、agent 工具调用审批、LLM-as-judge 打分、RAG 重排——d1 这类模型就是为你省钱的。按上面的估算,一个日均 10 万次分类调用的业务,从 GPT-6.1 Sol 切到 d1,一年省下的可能是几万到十几万美元量级。
但别急着全切。 三个保留:第一,数字是厂商一次性自测(2026 年 10 月 5 日,每应用每模型只跑一次,对手用默认推理设置的 JSON 输出),等第三方复现再信不迟;第二,d1 今天只有托管 API,没有权重,等于把分类命脉交给一家创业公司,SLA 和数据合规自己掂量;第三,System One 是私有协议,迁移成本真实存在,别为了省 token 钱把架构锁死。
和 Jev 怎么选? 目前信息还不足以分高下:Jev 背靠 TypeSafe 的类型安全生态,d1 背靠 Liquid 的液态网络研究且先上了视觉。务实的做法是,拿你自己的 500 条真实样本,两家都跑一遍校准曲线再决定——决策模型的选型,校准质量比榜单分数重要得多。
八、方法学备注(诚实声明)
本文性能与成本数字主要引自 Liquid AI 10 月 5 日官方博客,属厂商自报:每个应用每个模型在 2026 年 10 月 5 日各跑一次;GPT-6.1 Sol 与 Claude Opus 5.5 以单条 chat 消息 + JSON 输出、默认推理设置参与;成本按挂牌价计算、不含 prompt 缓存折扣;d1 成本按 $0.04/百万输入 token 计。第三方独立评测目前只有 GJOpen 上的 D1 vs Jev 对比(回顾性测试)。价格数字另经 OpenRouter d1 页面交叉核对($0.04 输入 / $0 输出)。
一句话总结:决策模型正在从"概念"变成"品类"——d1 用"输出 token 免费 + 长出眼睛"把分类类工作的成本打下来两个数量级,Jev 有了真正的对手;对用户来说,现在是拿自己的真实样本去实测两家校准质量的时候,而不是看榜单下单的时候。
来源
- Liquid AI 官方博客《Introducing d1: The most capable decision model, now with vision》(2026-10-05):https://www.liquid.ai/blog/d1-decision-model
- OpenRouter d1 模型页(价格与 Decisions API 说明):https://openrouter.ai/liquid/d1
- MarkTechPost《Liquid AI Releases d1》(2026-09-29):https://www.marktechpost.com/2026/09/29/liquid-ai-releases-d1-a-decision-model-that-returns-calibrated-probabilities-with-zero-output-tokens/
- datanorth《Liquid AI d1: decision model with zero output tokens》(2026-09-30):https://datanorth.ai/news/liquid-ai-releases-d1
- Utkarsh Ruhela《Liquid AI D1 vs Jev: GJOpen Forecasting Benchmark》(独立第三方对比):https://www.utkarshruhela.com/gjopen-answer-evaluation
- AIDailyPost《Liquid AI's d1 Model Skips Text, Returns Pure Probabilities》(2026-09-30,更新 10-01):https://aidailypost.com/news/liquid-ais-d1-model-returns-probabilities