 Grok
「1GB 装进口袋的智能体」:Liquid AI LFM3 一次放出六个 2B 模型,小模型第一次像回事了
小模型第一次像回事了:一个底座,六种活法
先说结论。Liquid AI 在 10 月 27 日放出了 LFM3,一共六个模型,全都长在同一个 1.7B 参数的底座上,覆盖文字、视觉、语音、全模态和决策五种活。最抓人的一组数字是浏览器任务:WebArena-Verified 上 LFM3-1.7B 拿到 38.42,前代 LFM2.5 只有 3.02,翻了 12 倍还多,甚至压过了 9B 的 Qwen3.5。但先别急着把大模型全换掉,这些分数都出自 Liquid 自己跑的评测,知识题和长上下文上它照样输给大块头。我的看法是,LFM3 值得看的地方不在"小打大"这个噱头,而在它把"一个手机能跑、一个 GPU 能改"的智能体做成了一件现成的事。
六个模型,一副骨架
LFM3 的思路和以往不太一样。多数厂商是一个尺寸打天下,或者一个模态一个模型,Liquid 反过来:先把一个 1.7B 的底座做扎实,再从上面分叉出六个专门化的版本。你要文字智能体就拿文字版,要看图就拿视觉版,要听声音就拿语音版,不用为用不上的能力付内存。
| 模型 | 吃什么 | 吐什么 | 参数 | 适合干什么 |
|---|---|---|---|---|
| LFM3-1.7B | 文字 | 文字 | 1.73B | 本地智能体、工具调用、结构化输出 |
| LFM3-VL-2B | 文字、图片、视频 | 文字 | 1.92B | 看文档、读图表、巡检图片、机器人视觉 |
| LFM3-Audio-2B | 文字、语音 | 文字、语音 | 约 2B | 语音聊天、转录、翻译、语音转工具调用 |
| LFM3-Omni-2B | 文字、图片、视频、语音 | 文字、语音 | 2.2B | 边看边听边说的助手 |
| d1-2B | 文字、图片、视频 | 结构化判定 | 约 2B | 工单分类、发票抽字段、图片框选 |
| d1-Omni-2B | 文字、图片、视频、语音 | 结构化判定 | 约 2B | 语音工单分流、电话录音判定 |
视觉版是 Liquid 第一个能吃视频的视觉模型,采样 2 帧每秒;语音版支持 18 种语言;d1 那两个最有意思,它们不写文章,只做判断:给一段工单、一张发票、一张截图和一串问题,一次前向传播就把所有问题答完,每个答案带一个校准过的概率。d1 还新加了四种答法:框选、抽值、估数、 多选。客服分流、票据审核这种活,以前要么调大模型慢慢生成,要么写一堆规则,现在有了一个中间选项。

三层混搭是怎么省内存的
省内存的办法不在某一个 trick,而在 24 层里三种算子的配比。13 层门控短卷积,负责近处模式,几乎不占缓存;5 层滑窗注意力,窗口 256 个 token,管段落级别的上下文;6 层全局注意力,负责真正需要跨长距离回望的时候。卷积核从 LFM2 的 3 加到了 7。Liquid 算过一笔账:这套组合的 KV 缓存只有同等深度标准 Transformer 的 27% 左右。
这个配比来自实测。Liquid 搞了一套硬件在环的架构搜索,在 14 种设备和后端组合上实测,三星 Galaxy S26 Ultra、OnePlus 15、树莓派 5、苹果 M4 Max、AMD Ryzen AI、高通 Hexagon NPU 都在里面。也就是说,层数比例按"在真机器上跑起来怎么样"调出来,服务器上的困惑度只是参考。
训练量也给得很实在。底座预训练 22T token,最后 3.5T token 是一个专门的中期训练阶段,里面塞了更多智能体轨迹和工具调用,上下文窗口也在这一步拉到 256K。后训练分四步:1.75T token 的监督微调、混合强化学习、六个专科强化教师蒸馏回一个模型,最后在 Hermes Agent、Pi、OpenClaw 这些真实智能体框架里跑任务练出来的强化学习。

跑分:浏览器任务上翻了十几倍,知识题上还是老实
先把话说在前面:下面所有分数都是 Liquid 自己公布的,截至发稿还没有第三方独立复现。信几分,你自己掂量。但即便打个折,表格里的反差也值得琢磨。
| 评测 | LFM3-1.7B | LFM2.5-2.6B | Qwen3.5-9B |
|---|---|---|---|
| WebArena-Verified(浏览器任务) | 38.42 | 3.02 | 28.94 |
| AutomationBench(业务应用任务) | 41.29 | 0.94 | 15.10 |
| BFCL V4(函数调用) | 71.39 | 55.89 | 62.83 |
| ToolSandbox(工具使用) | 80.36 | 78.04 | 76.41 |
| IFEval(指令遵循) | 96.66 | 95.39 | 92.08 |
| SWE-bench Verified(智能体编程) | 43.40 | 18.00 | 51.20 |
| GPQA Diamond(知识难题) | 63.37 | 57.78 | 80.40 |
| RULER 128K(长上下文) | 65.56 | 1.15 | 87.11 |
| MCP-Atlas(工具生态) | 32.57 | 16.45 | 42.67 |
| 29 项平均 | 49.37 | 31.55 | 47.24 |
读法很清楚。凡是"照着规矩把活干完"的任务,LFM3 占优;凡是"肚子里得有货"的任务,它就露馅。无工具的人类终极考试(Humanity's Last Exam)只有 7.17,官方文档也直说:别拿它做智能体编程和复杂多步推理,知识密集型任务请配检索和搜索。这份坦白比分数本身更可信。
视觉版的反差也类似。62 项视觉评测平均 71.4,从前代的 57.6 涨上来,追平了 12B 的 Gemma 4(71.7),文档、OCR 和图表这一类拿到 83.9。但数学和逻辑推理 68.8,离 Gemma 4 12B 的 79.3 还差一截。语音版 UTMOSv2 语音质量 3.83,比前代 3.22 高一截;全模态版在 Daily-Omni 上 70.1,压过 Qwen2.5-Omni-7B 的 61.3。d1-2B 比上一代 d1-3B 参数少了三分之一,决策基准 Decision Bench 反而从 83.6 涨到 85.2,图片规则判定 ImajevBench 从 64.0 涨到 75.5。
跑在手机上是什么感觉
数字之外,LFM3 最想让你记住的是"能跑在哪"。4-bit 量化后文字模型大约 1GB,装得进中端手机。Liquid 用 llama.cpp、Q4_0、32K 输入测了一圈:AMD Ryzen AI Max+ 395 生成速度 129.6 token/秒,苹果 M5 Max 237.1 token/秒,iPhone 17 Pro 43.6 token/秒,号称比同档下一个模型快 1.8 到 2.8 倍。128K 上下文的 KV 缓存只要 1.6GB,Qwen3.5-4B 同样长度要 4.3GB。服务器端,一块英伟达 B300 在 SGLang 下每天能吐 3.6B token,并发 1024 请求。
不过 1GB 这个说法要拆开看。它指的是模型文件本身,整个应用的内存账要另外算。VentureBeat 提醒过一句实在话:算部署预算的时候,模型、缓存、运行时和应用开销要分开算,128K 上下文的 1.6GB 只是 KV 缓存一项。我自己的建议也一样:先在你自己的机器和任务上跑一遍,别拿厂商的实验室数字当采购单。
上手门槛确实低。权重在 Hugging Face 上公开,GGUF、MLX、ONNX、FP8、NVFP4 格式齐全,llama.cpp、MLX、vLLM、SGLang、Ollama、LM Studio 都能跑,Liquid 还放了 10 个 Colab 微调笔记本,从抽 JSON 到教模型说新语言都有。文字版最短的上手代码就几行:
from transformers import pipeline

generator = pipeline(
    "text-generation",
    model="LiquidAI/LFM3-1.7B",
    trust_remote_code=True,
)

messages = [{"role": "user", "content": "What is C. elegans?"}]
output = generator(messages, do_sample=True, temperature=0.1,
                   top_k=50, repetition_penalty=1.1, max_new_tokens=2048)
print(output[0]["generated_text"][-1]["content"])
多少钱:托管 API 与自部署两本账
不喜欢自己搭环境的,可以直接调 Liquid 的托管 API。VentureBeat 从登录后的控制台里抄到了价目表,单位是每百万 token,美元计价:
| 模型 | 输入 | 缓存输入 | 输出 | 音频输入 | 音频输出 |
|---|---|---|---|---|---|
| LFM3-1.7B | $0.08 | $0.02 | $0.20 | 无 | 无 |
| LFM3-VL-2B | $0.10 | $0.02 | $0.50 | 无 | 无 |
| LFM3-Audio-2B | $0.10 | $0.02 | $1.00 | $2.00 | $10.00 |
| LFM3-Omni-2B | $0.10 | $0.02 | $1.00 | $2.00 | $10.00 |
按这个算,一百万输入加一百万输出,文字版花 0.28 美元。注意两个细节:托管版上下文标的是 128K,权重版的 256K 是另一回事;控制台还写着零数据留存,提交的内容不留存、不记日志、不拿去训练。至于许可证,LFM Open License v1.0 允许年收入 1000 万美元以下的公司免费商用,超过这个数要另外谈。自部署的账就更简单了:权重免费,成本只剩你自己的机器和电。
两个例子看微调这条路
Liquid 讲了两个微调例子,我觉得比跑分更能说明 LFM3 的定位。第一个是风机叶片巡检:拿 3000 张公开的风机照片,在一块 A100 上花几个小时做 SFT 加 GRPO,分类准确率从不到 10% 涨到 67%。但检测 F1 只从 0.003 涨到 0.11,GPT-6 Luna 是 0.01。也就是说,模型学会了"这是什么毛病",但"毛病在哪"还框不准,离无人巡检还远,离"有个会看图的助手"已经近了。
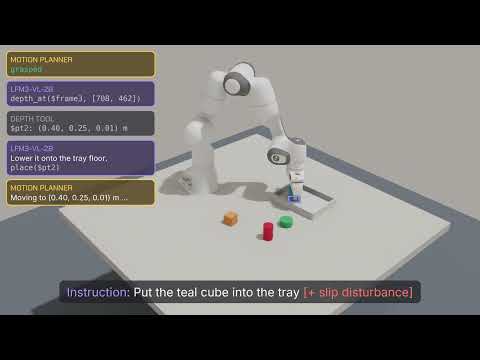
第二个是机器人。给视觉版接一个 rank-32 的 LoRA,大约 4 万条样本,单块 AMD Instinct MI325X 上 6 个 GPU 小时,就能在 Isaac Sim 里让机械臂按工具调用做关系选择、按实测属性分拣,还能在下一步图像里检查结果。视觉语言动作模型在 LIBERO 四套任务上平均成功率 96.2%,RoboCasa 桌面任务 45.7%,Jetson AGX Orin 上动作块生成不到 50 毫秒。Liquid 自己也承认这是研究方向的延伸,离量产部署还有距离,别把演示当产品。
合作方名单也值得扫一眼:梅赛德斯-奔驰在琢磨把本地 AI 放进 MBUX 车机助手,Shopify 参与了发布前测试,AMD、Ambarella、高通站台。MacPaw 的工程师在真实 macOS 环境里拿 65 个日常智能体任务测过:LFM3 成功率 64%,Qwen3.5-2B 是 48%,token 用量还少了 58%,卡住的比例不到 1%,对手是 15%。这组数字出自第三方之手,比官方表格多一点分量。
谁适合现在上手,谁再等等
写到这里,判断其实不难做。你的任务边界清晰、流程固定、数据不方便出内网,LFM3 这套东西现在就能试:工单分流、发票抽字段、文档读图、语音转工具调用,都是它的主场。一个 GPU 微调、手机上跑、零数据留存的托管版,这三条加起来,对很多小团队来说比"再租一个大模型 API"更划算。
反过来,你要的是写复杂代码、解难题、啃几十万 token 的长文档还不丢细节,那就别指望一个 2B 模型替你扛。它会在 MCP-Atlas、RULER 这些地方老老实实输给大模型。更稳妥的搭配是分工:LFM3 在端侧做高频、固定、便宜的活,碰上硬骨头再往上抛给大模型,检索和搜索挂在旁边补知识短板。
小模型这条线今年一直很热,Gemma、Qwen、Mistral 都在往端侧挤。LFM3 的不同之处在于,它没有把"小"当成"弱"的同义词,而是把架构、训练和部署三件事一起按端侧重做了一遍。浏览器任务上 12 倍的跳变,有多少是架构的功劳、多少是训练数据的功劳,第三方复现出来之前谁也说不准。但方向是对的:智能体这东西,最终要住进设备里。
一句话总结:LFM3 让手机、笔记本和内网服务器上也能体面地跑起智能体。
来源
- Liquid AI 官方博客:Introducing LFM3 https://www.liquid.ai/blog/lfm3
- Hugging Face 官方博客:Build specialized multimodal models with LFM3 https://huggingface.co/blog/LiquidAI/lfm3
- LFM3-1.7B 模型卡 https://huggingface.co/LiquidAI/LFM3-1.7B
- VentureBeat:Liquid AI's new LFM3 models put browser agents, voice commands, and image recognition onto enterprise-controlled devices https://venturebeat.com/technology/liquid-ais-new-lfm3-models-put-browser-agents-voice-commands-and-image-recognition-onto-enterprise-controlled-devices
- TechTimes:Liquid AI Releases LFM3 https://www.techtimes.com/articles/329588/20261028/liquid-ai-releases-lfm3-six-open-weight-models-fuse-text-vision-audio-one-2b-backbone.htm
- MarkTechPost:Liquid AI Releases LFM3 https://www.marktechpost.com/2026/10/27/liquid-ai-lfm3-open-weight-2b-multimodal-models/