137B 参数塞进 Windows:微软 Copilot 本地化,本地推理费用直接清零
小模型价格战的另一条路:让一部分 token 根本不用买
要点
- 微软 10 月 7 日宣布把自研代码模型 MAI-Code-1.1-Flash 搬上 Windows 本地:137B 总参数 / 6.8B 激活参数的 MoE 模型,经 3-bit 量化后塞进约 53GB,完整保留 256K 上下文,本地调用零推理费用。
- 量化几乎没掉能力:微软测试显示本地版 SWE-bench Verified 通过率 70.8%,云端全精度版 72.6%,差距不到 2 个百分点;在 Surface Laptop Ultra(RTX Spark 硬件)上短提示约 60 tokens/秒。
- GitHub Copilot 将自动在"本地"和"云端"之间选边:云端原有的 HydraFusion 路由扩展到 Windows,10 月底以实验性预览进入 Copilot App、Copilot CLI 和 VS Code;用户也可手动指定用本地模型。
- 配套还有三件事:MXC(Microsoft Execution Containers)给 agent 工具调用加沙箱隔离;Windows ML 支持 llama.cpp,开发者可选更多开源模型;NVIDIA Nemotron 70B+(2-bit,约 20GB)与 DeepSeek V4 Flash(284B)也将登陆 RTX Spark 硬件。
- 背景是"tokenmaxxing"退潮:今年夏天微软给各部门设了 AI token 预算,明确"拼 token 量不是优化目标";这次是把 agent 的高频调用搬到用户桌面,用本地算力对冲云账单。
2026 年 AI 圈的军备竞赛,大多发生在云端:更大的模型、更高的 API 价格、更长的上下文。但微软昨天(10 月 7 日)抛出的这组消息,方向正好相反——把模型装进你的电脑,让云端账单停下来。
对于每天和 Copilot、和代码打交道的人来说,这可能是今年下半年最值得关注的一次"降本":不是降价,而是直接把一部分 token 成本清零。

发生了什么:10 月 7 日的三连发
先把事实摆清楚。微软在 10 月 7 日的官方公告(microsoft.ai)和配套的 Windows/Copilot 更新里,一共说了四层意思:
- MAI-Code-1.1-Flash 上设备:用 3-bit 量化把模型体积压缩近 80%,完整保留 256K 上下文,在 SWE-Bench Verified 和 Terminal-Bench 2.1 上与全精度版本"表现相当"。官方原话是新版"更好、更快,成本只有四分之一"——而走本地路径的调用,推理费用直接为零。
- HydraFusion 路由进 Windows:GitHub 原来在云端用的任务路由系统 HydraFusion,现在扩展到 Windows,可以同时调度本地和云端模型。
- Copilot 三端接入:混合智能(Hybrid Intelligence)将于 10 月底以实验性预览进入 GitHub Copilot App、GitHub Copilot CLI 和 Visual Studio Code。
- 开发者生态配套:MXC 执行容器给 agent 的工具调用做沙箱隔离;Windows ML 加入 llama.cpp 支持,意味着开发者能把更多开源模型跑在 Windows 的 GPU/NPU/CPU 上。
据 unite.ai 与 WindowsReport 等多家媒体的交叉报道,这波 Copilot+ PC 的本地功能将在"未来几个月"陆续推送,具体节奏按设备、市场和芯片平台有所不同。
本地 137B 是怎么做到的:3-bit 量化的账
"137B 参数跑本地"听起来像营销话术,但微软这次给出了具体数字,值得细看:
| 指标 | 本地版(3-bit 量化) | 云端全精度版 |
|---|---|---|
| 总参数 / 激活参数 | 137B / 6.8B(MoE) | 137B / 6.8B(MoE) |
| 模型体积 | 约 53GB | —— |
| 上下文窗口 | 256K(完整保留) | 256K |
| SWE-bench Verified | 70.8% | 72.6% |
| Terminal-Bench 2.1 | 与全精度版相当 | 基准 |
| 推理速度(Surface Laptop Ultra) | 短提示约 60 tok/s,256K 长提示约 40 tok/s | —— |
| 满上下文峰值内存 | 约 75.5GB | —— |
| 推理费用 | 0 | 按云端计费 |
几个关键解读:
第一,量化损失比预期小。 SWE-bench Verified 上 70.8% 对 72.6%,差距 1.8 个百分点。rdworldonline 指出,微软这次是拿它跟另一个量化过的开源模型(OpenAI 的 gpt-oss-120b 量化版)对比,而不是跟旗舰闭源模型比——诚实,但也说明微软清楚本地模型的定位:不是替代旗舰,而是吃掉高频、低难度的调用。
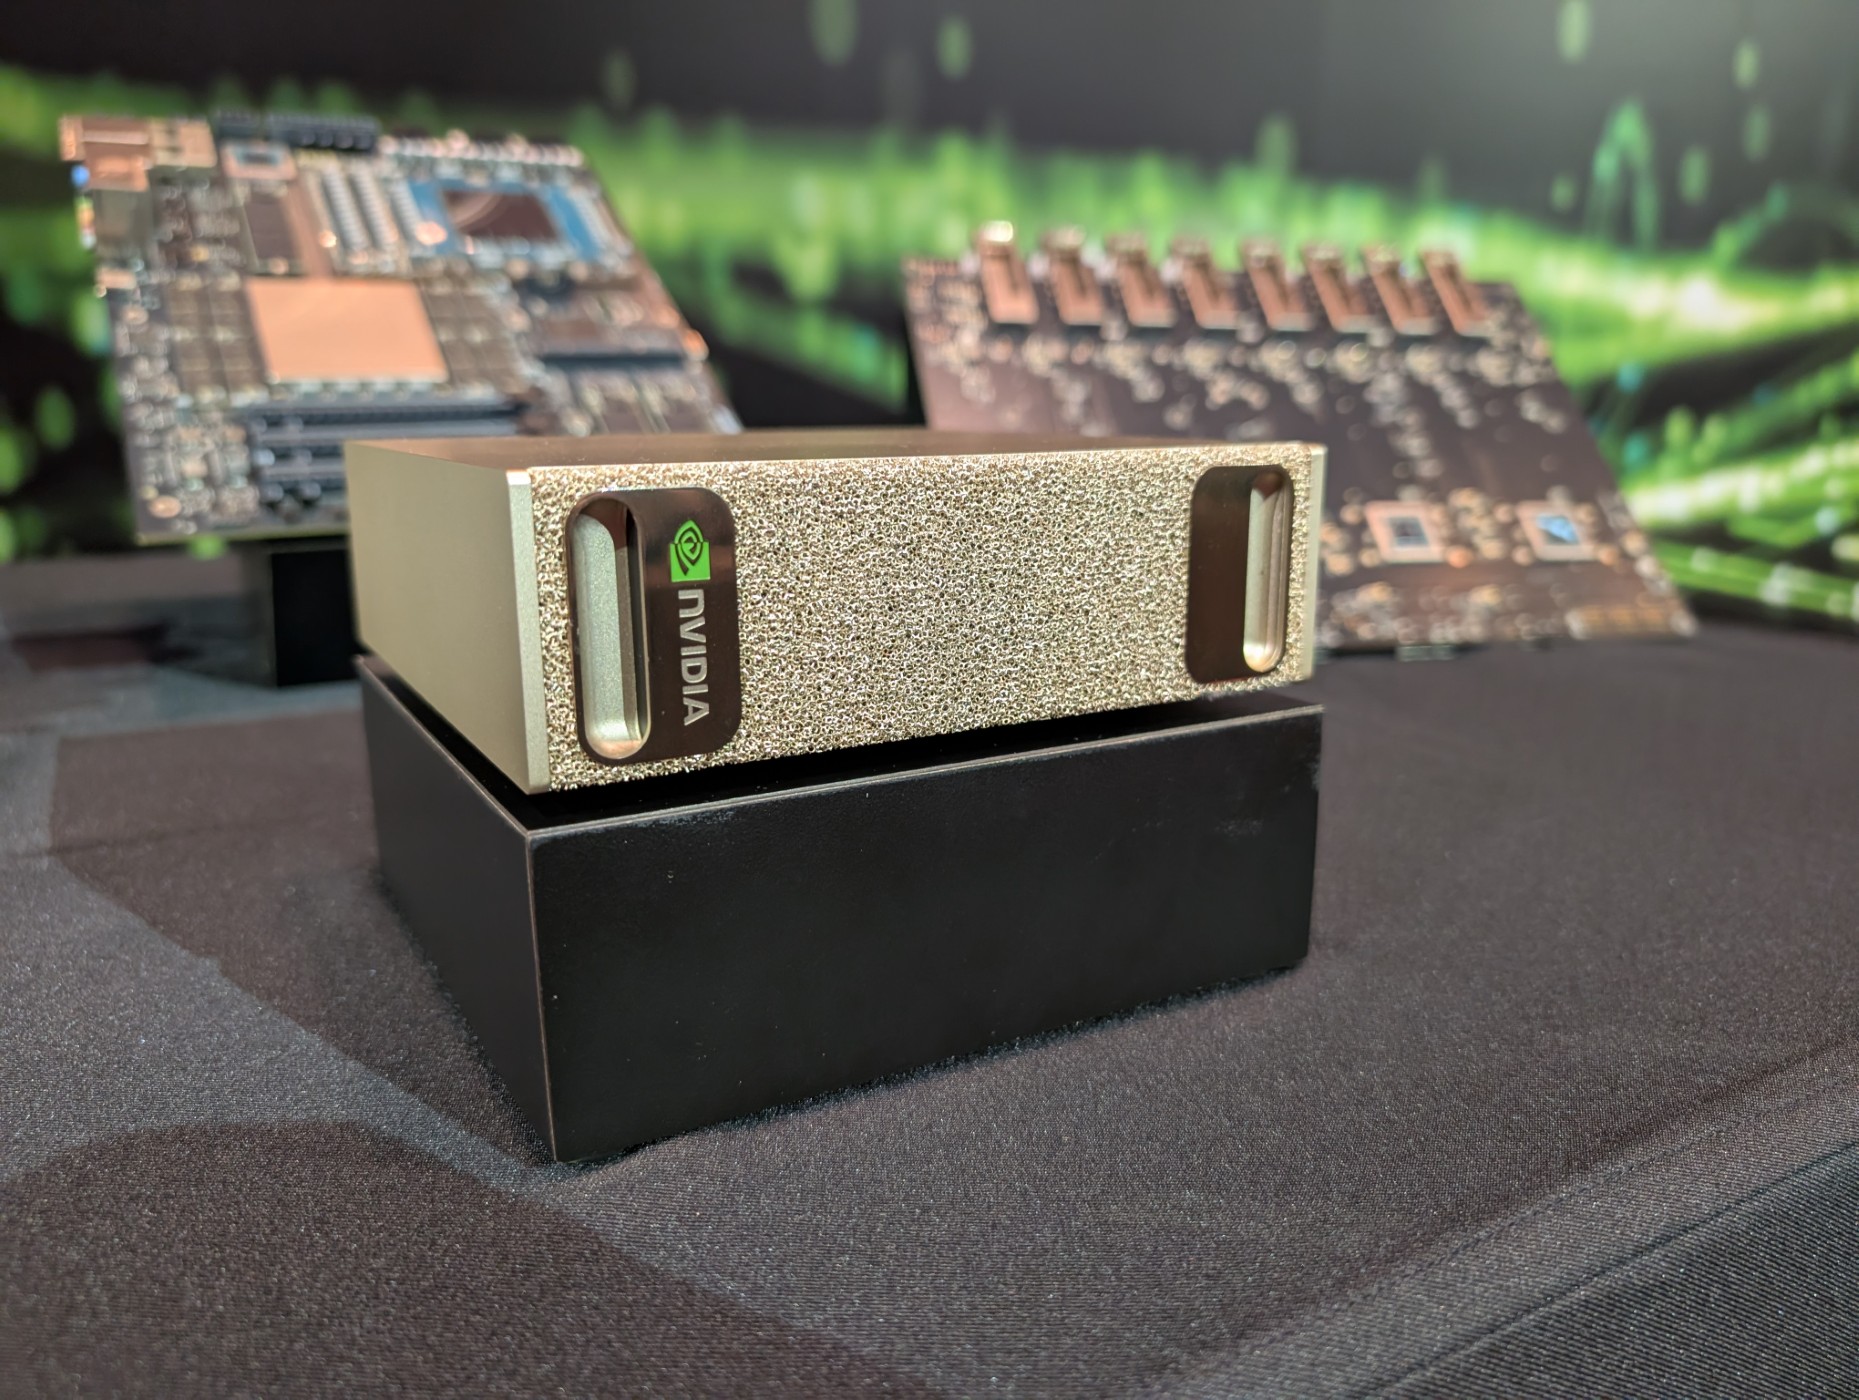
第二,硬件门槛是真实存在的。 模型本身 53GB,满上下文峰值内存 75.5GB,微软官方建议"120GB 以上内存的设备以获得最佳性能"。这基本把普通 16GB/32GB 笔记本排除在外,目标用户是 Surface Laptop Ultra(首批搭载,配 NVIDIA RTX Spark 硬件)这类 AI 工作站,以及公司里共享的 DGX Station 级设备。微软的设想甚至包括"7×24 开机的小主机跑 agent"和"一台 DGX Station 服务 32 人以上"。
第三,速度够用了。 60 tok/s 的短提示生成速度,写代码补全、改小函数这种场景完全跟手;长上下文掉到 40 tok/s 也在可接受范围。
HydraFusion:Copilot 学会"自动选边"
对用户来说,真正改变使用习惯的可能是路由层。GitHub 的 HydraFusion 原本是云端的多模型调度器,现在的扩展版本会自动判断每个请求走本地还是走云端:
- 自动编排(Auto orchestration):Copilot 自己决定。简单的补全、重构、测试生成走本地 MAI-Code-1.1-Flash;复杂的多文件重构、架构设计这类硬骨头,自动甩给云端大模型。开发者不用管 infra。
- 手动指定(Explicit local selection):通过 Windows ML provider 直接选本地模型,或者接到自己的本地 endpoint。适合对数据不出内网有硬性要求的场景——代码不经过微软服务器,隐私和合规一次到位。
据 dev.to 的技术解读,本地执行还会配合 MXC 沙箱:agent 写代码、跑测试、改文件这种"动真格"的操作,被关在隔离容器里执行,而不是直接在你的系统上裸奔。这是对 agent 编程工作流的一个重要补强——毕竟能自己动手改代码的模型,犯错的破坏力也更大。
微软还顺手宣布了另外两个上设备的模型:NVIDIA Nemotron 70B+ 参数版本用 2-bit 量化做到 20GB 出头就能跑,以及 DeepSeek V4 Flash(284B 参数)登陆 RTX Spark 硬件。本地模型的军火库正在快速变厚。
背景:tokenmaxxing 的退潮
理解这波操作,得看今年的一个关键词:tokenmaxxing。
2026 年上半年,企业界一度流行把"AI 花了多少 token"当生产力指标,token 烧得越多越显得"AI 化"。rdworldonline 的报道提到,这个夏天微软给内部各部门设了 AI token 预算,并明确告诉工程师:"tokenmaxxing 不是我们要优化的东西。"
逻辑很直白:agent 编程的特点是高频、重复调用——写一段、跑测试、失败、再改、再跑,一个任务下来几十上百次模型调用。全走云端,账单以 token 计价,烧得飞快;搬到本地,边际成本就是电费。微软自己披露的一个数字很能说明决心:全网 Copilot+ PC 每月已经在本地跑超过 2 万亿次推理,而且面向企业出货的笔记本里超过 40% 是 Copilot+ PC。本地推理不是实验,是已经成规模的基本盘。
对价格敏感的用户,这件事的意义可以用一段算术表达:
# 一个典型 agent 编程会话的成本对比(示意)
calls_per_session = 120          # 写码+测试+修复的迭代次数
tokens_per_call = 8000           # 平均每次调用 token 数
cloud_price_per_1m = 0.75        # MAI-Code-1-Flash 云端输入价(美元/百万token)

cloud_cost = calls_per_session * tokens_per_call / 1e6 * cloud_price_per_1m
local_cost = 0.0                 # 本地调用零推理费用(电费忽略不计)

print(f"云端: ${cloud_cost:.2f}/会话")   # 约 $0.72
print(f"本地: ${local_cost:.2f}/会话")   # $0.00
# 一天 10 个会话,一年 250 个工作日:云端约 $1800,本地约 $0
# 硬件是一次性投入,调用是边际零成本——这就是微软的算盘
当然,云端旗舰模型的能力税不会消失:HydraFusion 的设计本身就承认,难任务还得走云。但把 70-80% 的"体力活"从云账单里摘出来,对个人开发者和小团队是实打实的降本。
对你意味着什么
分三类人看:
Copilot 重度用户(个人开发者):10 月底实验性预览上线后,Copilot CLI / App / VS Code 里会出现本地模型选项。如果你的主力机内存够(64GB 起步,128GB 从容),简单任务可以零成本跑,云端额度留给真正难的问题。建议先拿"自动编排"模式跑一周,对比一下云端 token 账单的变化。
企业/团队:数据不出内网 + 零边际调用成本,这两个组合对金融、政企这类客户很有吸引力。一台共享的 DGX Station 级设备服务几十人,平摊下来比人均 Copilot 订阅的 token 账单可能更划算——当然,前期硬件投入要自己算账。
还在观望 AI PC 的人:微软这次等于给"为什么要买大内存 AI PC"写了一个具体答案。以前 Copilot+ PC 的 NPU 更多是跑小模型做 Recall、实时字幕这类点缀;现在 137B 代码模型能上机,内存大小直接决定了你能不能把主力工作流搬到本地。买机器时,内存优先级往上提。

一句话总结
微软把"降本"这件事从"API 降价"推进到了"调用清零":137B 的代码模型装进 Windows,Copilot 自动在本地和云端之间选边,高频的体力活不再产生 token 账单——小模型价格战的另一条路,是让一部分 token 根本不用买。
来源
- Microsoft AI 官方公告《MAI-Code-1.1-Flash: Better, faster, at a quarter of the cost》(2026-10-07):https://microsoft.ai/news/mai-code-1-1-flash-br-better-faster-at-a-quarter-of-the-cost/
- Unite.AI《Microsoft Gives Copilot Local File Context and OS-Wide Actions》:https://www.unite.ai/microsoft-gives-copilot-local-file-context-and-os-wide-actions/
- WindowsReport《GitHub Copilot Will Soon Switch Between Local and Cloud AI》:https://windowsreport.com/github-copilot-will-soon-switch-between-local-and-cloud-ai/
- RD World Online《After tokenmaxxing backlash, Microsoft moves more agent work onto the desk》:https://www.rdworldonline.com/after-tokenmaxxing-backlash-microsoft-moves-more-agent-work-onto-the-desk/
- DEV Community《Microsoft Brings MAI Code 1.1 Flash Local Inference to GitHub Copilot》:http://dev.to/alifar/microsoft-brings-mai-code-11-flash-local-inference-to-github-copilot-2j4d