「太空兔」摘面具了:MiniMax M3.1 Flash 今天发布,速度×3、成本降 70%、10 月 23 日开放权重
匿名 200T Token 盲测登顶的神秘模型现身:输入 1 元 / 百万 Token,国产 Flash 模型的性价比线被重新划定
结论:先说重点
- 今天发布:MiniMax M3.1 Flash 正式上线,已可通过 MiniMax API、M Plan 订阅、MiniMax Code 桌面端使用,定位是新一代 Flash 级别 Agentic 编程模型。
- 「太空兔」就是它:此前以匿名身份在各大榜单登顶、累计处理超过 200 万亿 Token 的神秘模型 Space Bunny,是 M3.1 Flash 的早期版本——榜单首位是靠真实跑量拿的。
- 速度翻倍级提升:线上推理速度接近 3 倍,日常场景输出 200+ TPS(每秒 Token),P50 稳定 170+ TPS,Agent 长任务跑起来明显更顺。
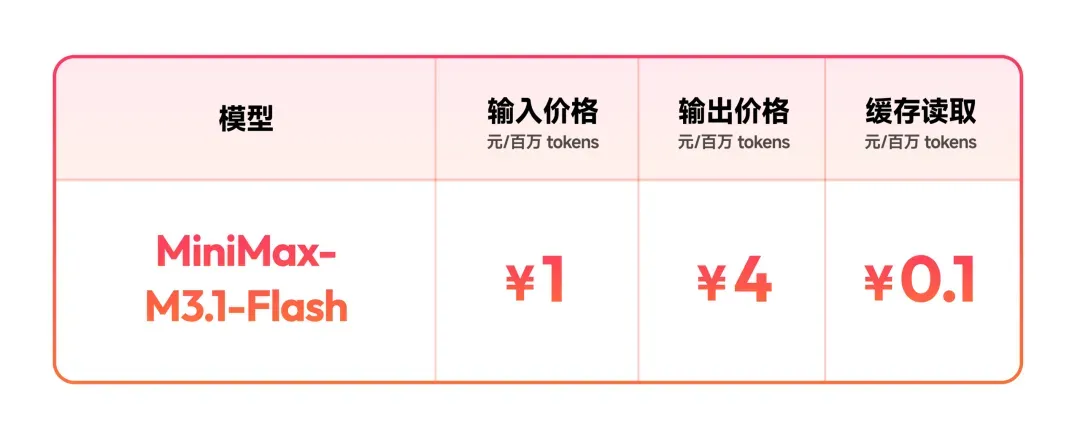
- 价格打到 1 元时代:输入 1 元 / 百万 Token,输出 4 元 / 百万 Token,缓存读取 0.1 元 / 百万 Token;Agent 类任务综合成本比前代降低 70%。
- 权重即将开放:MiniMax 已确认稍后开放模型权重(据 PC Watch 报道为 10 月 23 日),追求智能上限的 Pro 版本也将在随后到来。
「太空兔」摘下面具:匿名榜单之王是谁
过去几周,AI 榜单上出现了一个神秘身影:代号 Space Bunny(太空兔) 的匿名模型。它不公布身份、不开新闻发布会,却默默处理了超过 200 万亿 Token 的请求,在多个世界级排行榜上冲到第一——这相当于让全网用户在不知情的情况下,给它做了一次超大规模的盲测。
今天,MiniMax 在官方博客揭晓答案:Space Bunny 就是 M3.1 Flash 的早期版本。
这种玩法现在已经是新模型发布的标准动作:先以匿名身份上榜,用真实用户流量验证实力,等到榜单第一了再官宣。但 200T Token 这个量级值得注意——它不是一次小规模内测,而是接近公测体量的真实使用。对于开发者来说,这意味着 M3.1 Flash 的"首发日",其实已经经历了数月的生产环境验证。
跑分拆解:它到底强在哪里
官方公布了一组相当完整的评测。值得注意的是,这次的榜单刻意避开了纯文本考试,全部围绕 Agent 任务、编程、电脑操作、网络安全 四个实战方向:
| 评测 | M3.1 Flash 成绩 | 对照 |
|---|---|---|
| Automation-Bench v1.0.6(复杂业务自动化) | 62.2%,7 个模型中第 1 | DeepSeek-V4.1-Flash-1017:60.5%;Claude Opus 5:50.3% |
| DeepSWE v1.1(复杂软件工程) | 73.7% | DeepSeek-V4.1-Flash-1017:77.0%(第 1) |
| OSWorld V2(电脑操作) | 61.7,国产第 1 | — |
| Agents' Last Exam(真实电脑任务) | 29.6,国产第 1 | — |
| BankerToolBench(金融多步骤任务) | 76.2 | — |
| CyberGym(漏洞发现与验证) | 82% | — |
| BabyVision(看图推理,工具模式) | 91.0% | Claude Opus 5:94.1% |
读这份榜单要抓住两点:
第一,M3.1 Flash 的强项是"动手":跨 SaaS 系统的真实业务流程、长链路工具调用、电脑操作、代码审计和漏洞修补。Automation-Bench 测的是销售、营销、运营、客服、财务、HR 的真实企业工作流,能在这项拿第一,说明它对"AI 替人干活"这类场景做了专门优化。
第二,纯代码生成的极限它还没摸到顶:DeepSWE v1.1 上 73.7%,低于 DeepSeek-V4.1-Flash-1017 的 77.0%;BabyVision 看图推理也落后 Claude Opus 5 三个百分点。也就是说,如果你用它写算法竞赛题、做极致推理,它不是最强的;但如果你用它跑 Agent、做自动化、让它操作电脑——这是它的主场。
价格:每百万 Token 输入 1 元,意味着什么
这是本篇最值得开发者算的一笔账。官方定价(统一费率):
| 计费项 | 价格(人民币) | 价格(美元) |
|---|---|---|
| 输入 | 1 元 / 百万 Token | $0.15 / 百万 Token |
| 输出 | 4 元 / 百万 Token | $0.60 / 百万 Token |
| 缓存读取 | 0.1 元 / 百万 Token | $0.015 / 百万 Token |
对比它自己的前代:M3 的按量价格是输入 $0.30、输出 $1.20——M3.1 Flash 直接砍半。而官方宣称的"Agent 任务综合成本降低 70%",账面价格只降了一半,多出来的 30% 来自哪里?答案在输出侧:新模型针对 DeepSeek Harness、腾讯 CodeBuddy 等 Agent 开发框架做了优化,同样的任务输出更少、跑得更快。省 Token + 省单价,两头一挤,综合成本才降了 70%。
还有一个数字容易被忽略:缓存读取 0.1 元 / 百万 Token,只有标准输入价的十分之一。Agent 任务的特点是反复读同一份代码库、同一批文档,缓存命中率高——这个定价结构就是冲着长上下文 Agent 工作流去的。
横向看,这个价位把它直接放进了"Flash 价格带"的竞争核心区:输入 1 元 / 百万 Token 的国产 Flash 模型已经不少,但能同时在 Automation-Bench 拿第一的,这个价格目前只此一家。
速度:200+ TPS 的真实含义
官方称采用了"更激进的稀疏注意力架构",日常场景输出速度可达 200+ TPS,P50(中位数)稳定在 170+ TPS。
TPS 对普通聊天感知不强,但对 Agent 是质变:一个需要 50 轮工具调用、输出 20 万 Token 的长任务,在 60 TPS 的模型上要跑近 1 小时,在 200 TPS 下只要 17 分钟。结合上面说的"输出更短",实际任务耗时可能压缩到原来的四分之一。对跑 Coding Agent、自动化流水线的用户来说,速度提升带来的体验改善,可能比跑分提升更直接。
另外官方提到 100 万 Token 上下文、文本/图像/视频多模态输入、五档可调的推理强度(low/medium/high/xhigh/max)——这些是 Flash 定位下"按需付费算力"的标准配置,开发者可以根据任务难度手动拨档,难任务开 max,简单任务开 low 省钱。
怎么用:API、订阅、桌面端三条路
- API:已上线 MiniMax API 平台,按量计费,上面表格的价格即 API 价。
- M Plan:MiniMax 的 Token 订阅计划(官网 m-plan 入口),适合用量稳定的用户。
- MiniMax Code:桌面端 Coding Agent,直接下载即用,适合不想折腾 API 的开发者。
调用方式与 OpenAI 兼容,大致长这样(模型名以 MiniMax 官方文档为准):
from openai import OpenAI

client = OpenAI(
    base_url="https://api.minimax.io/v1",
    api_key="你的 MiniMax API Key",
)

resp = client.chat.completions.create(
    model="MiniMax-M3.1-Flash",  # 以官方文档公布的模型名为准
    messages=[{"role": "user", "content": "用 Python 写一个快速排序,并附带测试用例"}],
    extra_body={"reasoning_effort": "high"},  # 五档推理强度可调
)
print(resp.choices[0].message.content)
权重开放与 Pro 版本:接下来看什么
官方明确了两件事:模型权重稍后开放(据 PC Watch 报道,计划在 10 月 23 日公布权重与许可细节),以及追求智能上限的 Pro 版本随后到来。
权重开放值得单独盯一下:M3 的权重此前采用 MiniMax Community License——非商用免费、年营收 2000 万美元以下只需署名即可商用。如果 M3.1 Flash 沿用同样许可,本地部署和私有化 Agent 方案的成本会再下一个台阶。10 月 23 日见分晓。
给开发者的选购建议:什么时候该用它
如果你正在选 Flash 级别的模型,可以按场景对号入座:
- 跑 Coding Agent / 自动化流水线:M3.1 Flash 目前是国产选项里"任务成本最低"那一档——输入价 1 元 / 百万 Token 只是账面,真正省钱的是输出更短、缓存更便宜、速度更快,长任务的时间成本和 Token 成本双降。
- 需要它"动手"而不是"动嘴":让它操作电脑、跨应用执行任务、做代码审计和漏洞修补,是它跑分最强的地方;OSWorld V2 和 ALE 两项国产第一不是摆设。
- 纯推理难题、算法竞赛:DeepSWE 上它输给了 DeepSeek-V4.1-Flash-1017,极限代码能力不是它的主场,这类任务可以继续用更强的推理模型,或者等 Pro 版本。
- 本地部署 / 私有化:先别急,10 月 23 日权重开放后再看许可条件。如果沿用 M3 的 Community License(非商用免费、小团队署名即可商用),私有化 Agent 的成本会再降一档。
一句话:它是为"干活"而不是为"考试"生的模型——你的工作流里 Agent 越多,它越划算。
一句话总结
M3.1 Flash 不是一次"参数更大"的升级,而是一次"同样的活,更快、更便宜"的升级:匿名 200T Token 的盲测证明了实力,1 元 / 百万 Token 的输入价重新定义了国产 Flash 模型的性价比线——接下来就看 10 月 23 日的权重开放和 Pro 版本,能不能把这条线再往前推一把。
来源
- MiniMax 官方博客(中文):https://www.minimax.cn/blog/minimax-m31f
- MiniMax 官方博客(英文):https://www.minimax.io/blog/minimax-m31f
- 新浪科技 / 网易智能:「MiniMax发布M3.1 Flash:推理速度提升近3倍,Agent任务成本降低70%」:https://finance.sina.cn/stock/jdts/2026-10-19/detail-inivumae0907046.d.html
- PC Watch(日文):「あの覆面AIの正体は「MiniMax M3.1 Flash」10月23日にオープンウェイト公開」:https://pc.watch.impress.co.jp/docs/news/2149440.html
- Frontier Now:「MiniMax M3.1-Flash: 1M context, subscription」:https://frontiernow.dev/en/news/minimax-m3-1-flash/